Articolo
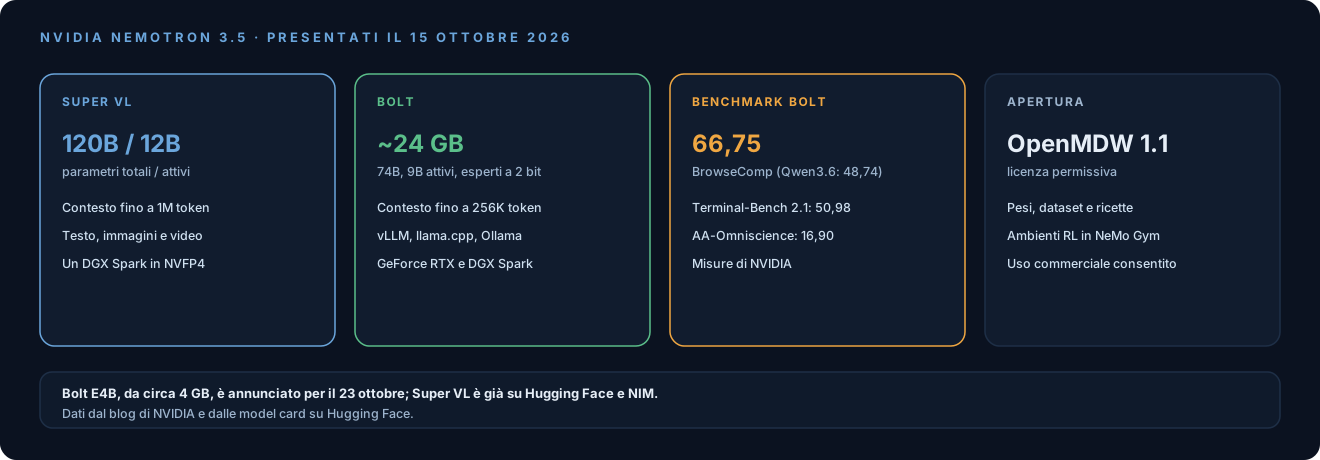
Il 15 ottobre NVIDIA ha presentato tre nuovi modelli della famiglia Nemotron 3.5, pensati per far girare agenti AI dal data center fino ai PC:
- Nemotron 3.5 Super VL, 120 miliardi di parametri con 12 miliardi attivi, multimodale;
- Nemotron 3.5 Bolt 74B-A9B, 74 miliardi di parametri con 9 attivi, compresso in circa 24 GB;
- Nemotron 3.5 Bolt E4B, da circa 4 GB, annunciato per il 23 ottobre.
Insieme ai pesi NVIDIA pubblica dataset aperti (uso di tool, finanza, contesti lunghi, visione e altro), le ricette di addestramento e gli ambienti di reinforcement learning in NeMo Gym. I modelli sono distribuiti con la licenza OpenMDW 1.1, che consente l’uso commerciale.
Super VL
Dalla model card su Hugging Face:
- Architettura ibrida Mamba-2 e Transformer con Mixture of Experts (512 esperti per livello MoE), encoder visivo C-RADIO e multi-token prediction per il decoding speculativo.
- Contesto fino a 1 milione di token; in ingresso testo, immagini e video fino a 2 minuti, in uscita testo. Il ragionamento si attiva o disattiva dal chat template.
- Pesi NVFP4, ottenuti con quantization-aware distillation dal modello BF16.
- Hardware indicato: un DGX Spark, una H200, due H100 o un GB200.
- Addestramento: circa 26.000 miliardi di token in pre-addestramento, poi circa 3,8 milioni di esempi di post-addestramento con reinforcement learning su decine di ambienti, secondo il blog di NVIDIA.
La model card confronta solo la versione NVFP4 con quella BF16: GPQA Diamond 89,9, SWE-bench Verified 71,07, Terminal-Bench 2.1 62,78, OSWorld-Verified 52,3, valori quasi invariati rispetto a BF16. La quantizzazione pesa invece su WebVoyager (da 77,72 a 66,31) e DeepSWE (da 24,65 a 18,2). I confronti con altri modelli sono nel blog di NVIDIA ma senza numeri.
Bolt 74B-A9B
Bolt è ricavato da Super VL per stare nella memoria di una sola GPU:
- Stessa architettura ibrida, con 9 esperti attivi per token invece di 22.
- Quantizzazione mista: esperti a circa 2 bit (IQ2-XXS), livelli Mamba in NVFP4, embedding e output in Q8_0, con quantization-aware distillation per recuperare accuratezza. Il modello compresso occupa circa 24 GB, dimensionato per batch singolo e 128.000 token di contesto.
- Contesto fino a 256.000 token, ingresso testo, immagini e video.
- Runtime: vLLM (la ricetta della model card richiede un’immagine nightly), SGLang e la versione GGUF per llama.cpp, Ollama e LM Studio. NVIDIA lo indica per GeForce RTX, RTX PRO e DGX Spark.
I benchmark della model card, misurati da NVIDIA, confrontano Bolt a 2 bit con modelli di taglia simile in BF16:
| Benchmark | Bolt (2 bit) | Qwen3.6 35B-A3B | Gemma4 26B-A4B |
|---|---|---|---|
| GPQA Diamond | 86,43 | 83,40 | 79,61 |
| Terminal-Bench 2.1 | 50,98 | 44,38 | 37,22 |
| BrowseComp | 66,75 | 48,74 | 26,30 |
| PinchBench | 87,82 | 88,07 | 74,70 |
| AA-Omniscience (accuratezza) | 16,90 | 19,47 | 22,17 |
Bolt è avanti sulla maggior parte delle prove, quasi alla pari su PinchBench e indietro sulla conoscenza fattuale misurata da AA-Omniscience. Il blog di NVIDIA lo presenta come primo modello aperto della sua classe su PinchBench, mentre nella tabella della model card Qwen3.6 35B-A3B è di poco avanti. La model card segnala anche che per MCP-Atlas il valore di Qwen3.6 misurato da NVIDIA (51,2) è più basso di quello dichiarato da Alibaba (62,8): i confronti dipendono da come si eseguono le prove.
La licenza
OpenMDW 1.1 consente di usare, modificare e distribuire i materiali del modello senza restrizioni d’uso né soglie di fatturato. Chi li ridistribuisce deve mantenere il testo della licenza e le note di copyright; i diritti decadono per chi avvia una causa sostenendo che i materiali violano un brevetto o un diritto d’autore. È un’impostazione più semplice di quella della Muse Model License di Meta, che prevede attribuzione obbligatoria e un accordo separato per chi offre il modello come servizio oltre una soglia di ricavi.
Cosa cambia per gli agenti in sede
Una settimana fa parlavamo di un modello open weight che richiede almeno 700 GB di memoria GPU. Questi due vanno nella direzione opposta: Super VL è indicato per un singolo DGX Spark, cioè una macchina con NVIDIA GB10 e 128 GB di memoria unificata, e Bolt in circa 24 GB. Per un’organizzazione che vuole far girare agenti su documenti, terminale e browser senza mandare dati all’esterno, la soglia hardware si abbassa a una workstation.
Due cautele. La prima: i numeri sono di NVIDIA e una quantizzazione a 2 bit va provata sui propri compiti, perché la stessa model card di Super VL mostra perdite su alcune prove agentiche. La seconda: un modello pensato per usare terminale e browser va messo dentro un perimetro con permessi espliciti, log delle azioni e approvazione umana delle operazioni con impatto.
Cosa ne pensiamo
La novità più utile non è un punteggio ma la combinazione: pesi, dataset e ricette aperti, licenza permissiva e modelli dimensionati sull’hardware che un’azienda può tenere in sede. Fra le piattaforme che usiamo per i progetti on-premise c’è anche il GB10, e un modello multimodale da 120 miliardi di parametri che ci sta per intero amplia ciò che si può fare in locale. Restano da vedere valutazioni indipendenti e prestazioni reali con contesti lunghi e più utenti.
Cosa monitorare
- L’uscita di Bolt E4B, annunciata per il 23 ottobre.
- Le valutazioni indipendenti di Super VL e Bolt, a partire da Artificial Analysis.
- Il supporto stabile di vLLM, oggi legato a un’immagine nightly per Bolt.
- Le prestazioni reali su DGX Spark con contesti lunghi e più sessioni.
Fonti
- NVIDIA Blog, Open from data center to desktop: Nemotron 3.5 Super VL and Bolt
- NVIDIA Developer, Nemotron 3.5 Super VL
- Hugging Face, model card di Nemotron 3.5 Super VL 120B-A12B NVFP4
- Hugging Face, model card di Nemotron 3.5 Bolt 74B-A9B 24GB
- NVIDIA Research, Nemotron 3.5 Bolt 24GB
- OpenMDW License 1.1
- Muse Spark Open di Meta: pesi, licenza e benchmark
- NVIDIA GB10: l’AI locale arriva sulla scrivania con 128 GB unificati