Sommario
- Quello che il machine learning sa da sempre
- Perché TypeSafe dichiara una latenza inferiore
- Le tre primitive
- La prima chiamata
- L’SDK Python
- Come si usa la confidence
- Come replicarlo con pesi aperti
- Chi lo ha già impacchettato
- Quello che il solo decoding vincolato non replica: la calibrazione
- Cosa ne pensiamo
- Fonti
Intelligenza Artificiale
Consulenza EU AI Act: classificazione dei sistemi, policy, governance AI, formazione.
Scopri →
Cybersecurity
Consulenza CISO-as-a-service: postura, roadmap di remediation, supporto continuativo.
Scopri →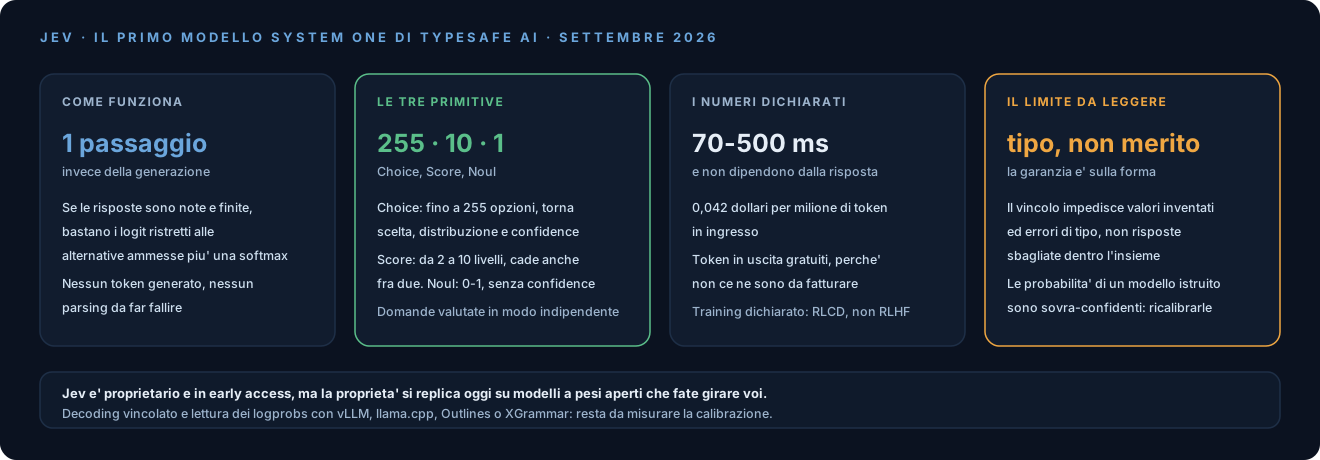
TypeSafe AI ha aperto l’accesso a Jev, che l’azienda presenta come il primo modello System One. L’azienda è fondata da Diogo Almeida, che viene da OpenAI. Il modello è in early access con lista d’attesa, proprietario e raggiungibile via API ospitata.
Il nome viene da Kahneman e lo dice la documentazione stessa: “The System One name comes from the concept Daniel Kahneman popularized in his book Thinking, Fast and Slow”, dove il sistema 1 è il pensiero rapido e intuitivo. È un’etichetta scelta da TypeSafe per il proprio prodotto, non una categoria già condivisa dal settore.
La descrizione che ne fa TypeSafe è insolita e merita di essere presa alla lettera: Jev rinuncia alla generazione di stringhe. Non produce testo. Riceve uno stato e delle domande tipizzate e restituisce valori strutturati con una distribuzione di probabilità sopra.
Questo articolo spiega il principio, mostra qual è l’endpoint e come si costruisce una richiesta, poi mostra come ottenere una proprietà analoga con modelli a pesi aperti che potete far girare voi.
Quello che il machine learning sa da sempre
Prima del meccanismo vale la pena dire una cosa che a chi lavora con il machine learning da prima dei modelli linguistici, noi compresi, suona molto familiare.
Un classificatore ha sempre fatto esattamente questo. Si definisce l’insieme delle classi, si addestra il modello su quelle e l’ultimo strato restituisce una distribuzione di probabilità sull’insieme. Non c’era un passo di parsing perché non c’era testo da interpretare, e l’uscita era già un numero per ogni classe ammessa.
Anche la calibrazione è un argomento vecchio. I diagrammi di affidabilità, il Platt scaling e la temperature scaling stanno nei manuali da molto prima di questa stagione, e la letteratura sulle reti profonde sovra-confidenti ha quasi dieci anni. Chiunque abbia messo in produzione un classificatore per un supporto diagnostico, per un instradamento o per un controllo di qualità ha dovuto guardare quella curva prima di fissare una soglia, perché è lì che si decide quando la macchina agisce da sola.
C’è poi la parte economica, che sul lungo periodo pesa parecchio. Su un compito stretto, con tassonomia stabile e dati etichettati rappresentativi, un classificatore specializzato può risultare più economico e anche più accurato di un modello generale. Non è una garanzia, ed è bene dirlo: il vantaggio dipende dalla qualità dei dati, dalla copertura degli input, dalla frequenza del drift e dal costo di manutenzione. Quando il vantaggio c’è, però, si vede su tre voci. L’addestramento spesso si misura in ore su una scheda sola. L’inferenza è un passaggio su un modello piccolo, che in molti casi gira anche su CPU, a seconda di dimensione, latenza e volume richiesti. E il riaddestramento resta un’operazione ripetibile: cambia la tassonomia o deriva la distribuzione, si rietichetta, si riaddestra e si confronta la metrica con quella di prima.
Quest’ultimo punto è il più sottovalutato. Con un classificatore il riaddestramento ha un numero che dice se è andata meglio o peggio. Anche un sistema basato su prompt può avere la stessa disciplina, con una suite di valutazione e test di regressione sulle risposte: il problema è che quel banco di prova, nella pratica, spesso non viene costruito, e allora la regressione si scopre in produzione.
Quello che è cambiato negli ultimi anni è l’interfaccia. I modelli linguistici hanno reso il testo il canale universale, e con il testo è arrivata l’abitudine di chiedere una classificazione dentro un prompt, farsela restituire in JSON e riportarla a valore con un parser. La strada del modello generale resta la sola possibile quando i dati etichettati non ci sono, quando l’insieme delle risposte cambia di continuo o quando servono conoscenze del mondo che un classificatore addestrato in casa non ha. Dove invece l’insieme è noto e i dati ci sono, è un giro attorno a un problema che la disciplina aveva già risolto in un altro modo e a un costo diverso.
Vista così, la novità di un modello come Jev è meno una rottura e più un richiamo a un metodo: si sceglie prima quali sono le risposte ammesse, si misura quanto il modello è affidabile su quelle e si legge il numero. È anche la ragione per cui la parte utile di questo rilascio si applica senza Jev e occupa metà di questo articolo.
Perché TypeSafe dichiara una latenza inferiore
Il principio è semplice e vale la pena isolarlo, perché spiega la forma dei numeri dichiarati.
Un LLM genera testo un token alla volta. Per ottenere una decisione strutturata da un LLM si scrive un prompt che chiede di rispondere in JSON, il modello genera quei token uno dopo l’altro e il codice chiamante fa il parsing e la validazione di quello che è tornato. La latenza dipende dalla lunghezza dell’output, e il passo di parsing può fallire.
Quando le alternative sono finite, però, un sistema non deve necessariamente produrre una risposta testuale token per token: può calcolare direttamente punteggi o probabilità sulle opzioni ammesse. È la tecnica che sta dietro alla parte open weight di questo articolo, dove si fa un passaggio in avanti sul modello, si guardano i logit ristretti alle alternative e si applica una softmax.
Su Jev va detto con precisione che cosa sappiamo. TypeSafe dichiara una nuova architettura con un parallel sampler hardware-aware che restituisce le decisioni in parallelo. I materiali pubblici non descrivono il modello con un dettaglio sufficiente per ricondurlo a un normale LLM su cui si leggono i logit in un unico forward pass: quella è una tecnica possibile e usata da alcune implementazioni aperte, non una descrizione verificata di Jev.
I numeri sono del fornitore. TypeSafe dichiara una latenza end-to-end fra 70 e 500 ms, 0,042 dollari per milione di token in ingresso e nessun prezzo separato per i token in uscita. Sono misure e condizioni commerciali pubblicate da chi vende il servizio, da verificare su carico, regione e versione del modello che userete davvero.
Anche la formula “la latenza non dipende dalla risposta” va usata con cautela. Non cresce in modo autoregressivo con la lunghezza di una stringa generata, il che è il punto. Può però dipendere dalla lunghezza dello stato, dal numero di domande, dalla cardinalità delle opzioni, dal batching e dal carico del servizio. Sulle scelte a cardinalità alta lo dice TypeSafe stessa in una nota del post di lancio: “For the higher cardinality choices, we do a 2 stage-system of scoring independently then making an explicit choice, hence the occassional slowdown”.
TypeSafe aggiunge un pezzo suo sul training: al posto di RLHF dichiara di usare RLCD, Reinforcement Learning for Calibrated Decisions, ottimizzato per produrre probabilità oneste invece che risposte gradite a un valutatore umano. Su questo torniamo alla fine, perché è la differenza che conta.
Le tre primitive
Ogni richiesta valuta uno stato contro una o più domande. Tutte le domande vedono lo stesso stato e sono valutate in modo indipendente: aggiungerne o toglierne una non cambia le risposte alle altre.
Choice. Una scelta fra opzioni senza ordine fra loro. Si passa criteria come mappa da opzione a descrizione. Accetta fino a 255 opzioni. Torna choice con l’opzione selezionata, probabilities con la distribuzione su tutte le opzioni e confidence.
Su Choice c’è una raccomandazione della documentazione che conviene seguire sempre: quando la tassonomia potrebbe non coprire tutti gli input, va aggiunta un’opzione other o none of the above, “so the model can say none of the others fit”. Senza una via d’uscita il modello è costretto a scegliere anche davanti a un input che non appartiene a nessuna classe, e una distribuzione molto concentrata fra opzioni forzate non dimostra che una di esse sia adeguata.
Score. Una posizione su una scala ordinata. Si passa criteria come array ordinato di descrizioni dei livelli, da almeno 2 fino a 10. Torna score, che può cadere fra due livelli (nell’esempio della documentazione vale 1.035), più legend, probabilities e confidence.
Noul. Una domanda sì o no in cui il numero interessante è la probabilità stessa. Torna solo noul, un valore fra 0 e 1. Non ha confidence, e la documentazione avverte che 0,5 significa che il modello dà uguale probabilità a sì e no, non che la grandezza misurata stia a metà.
Su quest’ultimo punto la documentazione è esplicita con un esempio utile: “È questo candidato forte in Python?” è una domanda mal posta per un Noul, perché “forte” non è definito. Per misurare un livello serve uno Score con i livelli scritti; per una decisione binaria serve una condizione netta, come “il curriculum dichiara che il candidato ha usato Python al lavoro?”.
La prima chiamata
L’endpoint è uno solo.
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer <API_KEY>
Content-Type: application/json
Il corpo ha tre campi di primo livello: state, model e questions. Ecco una richiesta che fa le tre domande insieme su un ticket di assistenza.
{
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and it keeps failing. I'm losing sales. Please help ASAP.",
  "model": "jev-latest",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this",
      "criteria": {
        "billing": "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales": "Pricing or account questions"
      }
    },
    "frustration": {
      "type": "score",
      "instructions": "How frustrated the customer appears",
      "criteria": [
        "Calm, just stating facts",
        "Frustrated but civil",
        "Very angry, strong language"
      ]
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "The message conveys urgency or time-sensitivity"
    }
  }
}
La risposta arriva con tutte e tre le valutazioni in un colpo solo. L’esempio è ripreso dalla documentazione Quick Start, e va letto con due avvertenze: la pagina delle primitive elenca probabilities anche fra i campi di Score, mentre questo esempio non le mostra, quindi il payload effettivo va verificato contro la versione dell’API che usate.
{
  "model": "jev-latest",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "billing",
      "probabilities": { "billing": 0.84, "technical": 0.159, "sales": 0.001 },
      "confidence": 0.596
    },
    "frustration": {
      "type": "score",
      "score": 1.035,
      "legend": { "0": "Calm, just stating facts", "1": "Frustrated but civil", "2": "Very angry, strong language" },
      "confidence": 0.842
    },
    "is_urgent": { "type": "noul", "noul": 0.999 }
  },
  "usage": { "input_tokens": 312, "output_tokens": 48 }
}
Vale la pena guardare questa risposta con attenzione, perché contiene una lezione. Il modello sceglie billing con una probabilità dello 0,84, mentre la confidence vale 0,596: sono due numeri diversi e misurano cose diverse. La soglia oltre la quale automatizzare non si deduce da questo singolo caso, va scelta in funzione del rischio e validata su dati etichettati del vostro dominio. Uno score di 1,035 colloca il cliente appena sopra il livello “frustrato ma civile”, perché il punteggio può cadere fra due livelli.
Un’altra cosa che si legge nel payload: output_tokens vale 48. Il conteggio degli output esiste ed è riportato, mentre quello che TypeSafe dichiara è l’assenza di generazione autoregressiva e un prezzo commerciale pari a zero per quella voce. Sono tre affermazioni distinte e conviene non confonderle.
Lo state non deve essere una stringa: accetta anche oggetti e array JSON, ed è la forma da preferire quando il contesto ha parti distinte con un nome. Jev accetta solo testo, niente immagini, audio o video, e la lingua di addestramento primaria è l’inglese: la documentazione avverte che le altre lingue sono accettate con accuratezza inferiore. Per un ticket in italiano conviene misurarlo prima di fidarsi.
L’SDK Python
Serve Python 3.10 o superiore. Il client legge la chiave da TYPESAFE_API_KEY e usa jev-latest come predefinito.
pip install typesafe-sdkfrom typesafe_sdk import Choice, Noul, Score, TypeSafeClient
state = {
"ticket_message": (
"Hi, I've been trying to connect my Stripe account for 3 days "
"and it keeps failing. I'm losing sales. Please help ASAP."
)
}
client = TypeSafeClient()
response = client.system_one(
state=state,
questions={
"department": Choice(
instructions="Which team should handle this",
criteria={
"billing": "Payment or subscription issues",
"technical": "Bugs or integration problems",
"sales": "Pricing or account questions",
},
),
"frustration": Score(
instructions="How frustrated the customer appears",
criteria=["Calm, just stating facts", "Frustrated but civil", "Very angry, strong language"],
),
"is_urgent": Noul(instructions="The message conveys urgency or time-sensitivity"),
},
)
print(response.answers["department"].choice) # "billing"
print(response.answers["frustration"].score) # 1.035
print(response.answers["is_urgent"].noul) # 0.999Come si usa la confidence
Questa è la parte che cambia davvero il codice che scrivete, e non richiede Jev per essere applicata.
La confidence è una statistica calcolata sulla forma di probabilities: una distribuzione concentrata su un’opzione dà confidence alta, una distribuzione piatta la dà bassa. Va letta per quello che è. Una confidence di 0,596 non significa che la scelta abbia il 59,6% di probabilità di essere corretta: è un indice di concentrazione definito dal fornitore. La probabilità della prima opzione, la confidence e l’accuratezza empirica sono tre quantità diverse, e solo la terza si misura su dati etichettati.
La documentazione lo dice chiaramente e aggiunge una cosa onesta, cioè che la loro definizione è un default comodo e che restituiscono l’intera distribuzione proprio perché possiate calcolarvi la misura che vi serve.
Il pattern suggerito divide in tre fasce e ricalca quello che in un sistema serio si fa comunque:
- Confidence alta: si agisce in automatico.
- Confidence media: si procede con cautela, chiedendo conferma all’utente o marcando il caso per revisione.
- Confidence bassa: non si agisce e si passa a una persona.
Nel disegno vero servono però anche le cose che quel numero non vede. Un input fuori distribuzione o privo dell’informazione necessaria può produrre una distribuzione concentrata e sbagliata, quindi accanto alle soglie vanno previsti un’opzione di astensione esplicita, un percorso di ricaduta su una persona, soglie diverse per azioni reversibili e irreversibili e un monitoraggio del drift che dica quando la taratura di ieri non vale più.
Il valore di questo schema sta in una frase della documentazione che vale a prescindere dal fornitore: un sistema che non sa esprimere incertezza in modo onesto non è un sistema di cui ci si possa fidare. È lo stesso principio su cui insistiamo parlando di anatomia di un loop agentico: la soglia che decide quando fermarsi va scritta prima, non dedotta dopo.
Come replicarlo con pesi aperti
Jev è proprietario, ospitato e dietro lista d’attesa. La proprietà dell’output vincolato su alternative finite però non è esclusiva di Jev e si implementa con strumenti open source, su modelli che girate voi. Chiariamo cosa si replica facilmente e cosa no.
Il vincolo sulla forma si ottiene in diversi modi, tutti open source e tutti maturi.
Con vLLM si usano le structured outputs. Attenzione alla versione, perché l’API è cambiata: i vecchi campi guided_* sono stati rimossi in vLLM 0.12.0 e sostituiti da structured_outputs. Il frammento che segue è quello documentato per vLLM 0.12 e successivi, e resta da verificare contro la versione che avete installata.
from vllm import LLM, SamplingParams
from vllm.sampling_params import StructuredOutputsParams

llm = LLM(model="Qwen/Qwen3-8B")

structured = StructuredOutputsParams(choice=["billing", "technical", "sales"])
params = SamplingParams(structured_outputs=structured)

out = llm.generate(prompt, params)
print(out[0].outputs[0].text)
Questo blocco garantisce la forma dell’uscita: il testo prodotto sarà una delle tre etichette. Non restituisce da solo la distribuzione sulle alternative, che è un problema distinto e più delicato.
Con llama.cpp si ottiene lo stesso con una grammatica GBNF, che descrive la forma ammessa e la impone durante il decoding:
root ::= "billing" | "technical" | "sales"Ci sono poi Outlines e XGrammar, quest’ultimo usato come motore di structured generation dentro vLLM e SGLang.
La distribuzione, cioè la parte che rende la risposta utilizzabile come segnale e non solo come etichetta, si ricava dai logprobs normalizzando sulle sole alternative ammesse. La formula è questa, scritta come schema concettuale e non come esempio eseguibile, perché il modo di ottenere quei valori cambia da motore a motore.
import math

# lp_* sono i logprob dei token che identificano le opzioni.
# Come recuperarli dipende dal motore: su vLLM si passa da logprobs
# oppure da prompt_logprobs, su Transformers dai logit dello step.
cand = {"billing": lp_billing, "technical": lp_technical, "sales": lp_sales}
z = sum(math.exp(v) for v in cand.values())
probs = {k: math.exp(v) / z for k, v in cand.items()}

# Indice euristico di separazione fra le prime due alternative.
# Non è la confidence di TypeSafe e non è una probabilità
# calibrata di correttezza.
ordered = sorted(probs.values(), reverse=True)
margin = ordered[0] - ordered[1]
Prima di appoggiarci sopra qualcosa, i limiti di questa strada vanno conosciuti tutti.
- Il
logprobstop-k dei motori restituisce poche decine di candidati: con 255 alternative non basta, e servono scoring di sequenza o un albero di prefissi. - La tokenizzazione decide. Spazi iniziali, maiuscole e lingua cambiano i token candidati, quindi le etichette vanno controllate con il tokenizer del modello che userete invece che date per buone.
- Le label su più token non si risolvono con un solo passaggio sul primo token: o si punteggia la sequenza intera, o si costruisce un albero di prefissi.
- Normalizzare sulle sole alternative produce una distribuzione condizionata all’insieme imposto, che è un’altra cosa rispetto a una probabilità sul mondo. Se nessuna opzione è adeguata, quella normalizzazione lo nasconde.
- Una distribuzione condizionata non è automaticamente calibrata, ed è il tema della sezione successiva.
- Senza un’opzione
other, unnone_of_the_aboveo un meccanismo di astensione, il modello è costretto a scegliere anche quando tutte le opzioni sono inadeguate.
Un accorgimento pratico che aiuta quando le condizioni ci sono: se le etichette divergono al primo token il conto si semplifica molto. Con refund_full e refund_partial non succede, perché condividono il prefisso. Rinominatele o numeratele, dopo avere verificato con il tokenizer che la separazione avvenga davvero dove pensate.
Chi lo ha già impacchettato
Nei giorni successivi all’annuncio sono comparsi diversi progetti aperti che implementano la stessa idea. Vanno presi per quello che sono: i repository citati qui risultano tutti creati fra il 16 e il 19 settembre, controllando le date di creazione via API GitHub, quindi materiale da leggere e da provare, non da mettere in produzione questa settimana. Il codice però è istruttivo, e tre di questi prendono strade diverse che vale la pena confrontare.
open-alternative-jev (Apache-2.0) è il più vicino a quanto descritto sopra. È un pacchetto Python che si importa come so1 e risponde a ogni domanda dalla distribuzione del token successivo nella sua posizione, ristretta alle opzioni fornite, leggendo i logit solo nelle posizioni di lettura con logits_to_keep su Transformers o prompt_logprobs su vLLM. Funziona subito sui modelli con template ChatML, Qwen e molti fine-tune, mentre gli altri template richiedono un adattatore ChatFormat. Ha una demo su Hugging Face Spaces che gira senza installare niente.
Il merito del progetto è che pubblica anche i propri limiti, e vanno riportati. I suoi benchmark mostrano che la modalità packed, che scrive lo stato una volta sola per più domande, cambia alcune risposte rispetto alla valutazione separata, con un accordo intorno al 94%. Su vLLM la modalità separate risulta insieme più accurata e più veloce grazie alla prefix cache. Le probabilità grezze, scrive il progetto, non sono calibrate di partenza. È un’implementazione istruttiva, non una riproduzione verificata di Jev.
OpenJev (Apache-2.0) risolve un problema diverso: dichiara di parlare la stessa wire API di Jev. In pratica installate typesafe-sdk, puntate TYPESAFE_BASE_URL al vostro server e il codice scritto per Jev dovrebbe continuare a funzionare contro un modello vostro. Si distribuisce come immagine container con vLLM dentro, gira su DiffusionGemma 26B-A4B e con la stessa istanza serve anche generazione di testo su un endpoint compatibile OpenAI. È un progetto indipendente, dichiara di non essere affiliato a TypeSafe e compatibilità e prestazioni sono affermazioni sue che qui non abbiamo verificato.
vllm-jev-decison (MIT, e il refuso nel nome è del repository) è un plugin per vLLM che fa solo classificazione su schemi JSON finiti. La scelta di progetto interessante è che rifiuta gli schemi non supportati prima dell’inferenza e non prevede alcun fallback generativo. Chiede vLLM 0.29.0 e l’avvio con --logprobs-mode raw_logprobs e dichiara limiti espliciti: 32 campi, 16 candidati per campo, 64.000 caratteri di input.
La documentazione qui è la più severa del gruppo, e dice due cose che valgono per tutti. Uno schema valido non significa decisione corretta. E le probabilità condizionate sui candidati non sono stime calibrate di correttezza, tanto che il plugin riporta a parte un candidate_mass, cioè quanta probabilità grezza del vocabolario finisce davvero sulle etichette: è il numero che intercetta i casi che la confidence non vede.
Un quarto, Von (Apache-2.0), prende la strada più ambiziosa e addestra un modello proprio non autoregressivo, con i pesi pubblicati su Hugging Face. Su latenza, addestramento e calibrazione il progetto pubblica benchmark propri: sono numeri dichiarati dagli autori, non verificati da terzi, e vanno letti così. Esiste infine una lista curata che raccoglie progetti e integrazioni.
Il quadro da tenere a mente è questo. Replicare l’interfaccia, cioè input strutturato, alternative finite e uscita tipizzata, è relativamente semplice, e infatti è successo in pochi giorni. Replicare architettura, addestramento, comportamento probabilistico e calibrazione di Jev è un’altra cosa, e questi wrapper non lo dimostrano.
Quello che il solo decoding vincolato non replica: la calibrazione
Qui va detta la cosa scomoda, che è anche la ragione per cui un prodotto come Jev può esistere.
Il decoding vincolato garantisce la forma della risposta. Non garantisce che le probabilità significhino qualcosa. Le distribuzioni che leggete dal softmax di un modello istruito sono tipicamente sovra-confidenti: il modello dice 0,95 su cose che azzecca l’ottanta per cento delle volte. Se usate quel numero per decidere quando agire in automatico, state calibrando su un numero che non è calibrato.
Il rimedio esiste e non è esotico. La temperature scaling stima un solo parametro su un insieme di validazione etichettato, dividendo il vettore dei logit per quel valore, ed è spesso un buon punto di partenza: la descrive Guo et al. nel lavoro che ha reso popolare il problema delle reti moderne sovra-confidenti. Quanti dati servano non si può fissare una volta per tutte, perché dipende da numero e frequenza delle classi, dalle soglie operative e dal rischio accettabile.
La calibrazione va misurata su dati rappresentativi del dominio e ricontrollata quando cambia la distribuzione degli input, perché una taratura post-hoc si degrada sotto distribution shift: è il risultato di Ovadia et al., che conviene avere presente prima di considerare il problema chiuso.
Gli strumenti per guardarla sono noti: negative log-likelihood e Brier score come misure aggregate, il reliability diagram per vedere dove la curva si stacca dalla diagonale, l’ECE tenendo a mente che il valore dipende da come si scelgono i bin, le metriche per classe e per fascia di rischio invece della sola media e una curva risk-coverage che dica quanta accuratezza si ottiene sui casi che si è scelto di accettare.
RLCD è, per dichiarazione di TypeSafe, addestramento mirato proprio a questo. Non abbiamo modo di verificarlo dall’esterno, e le valutazioni pubblicate sono le loro.
Va trattato con la stessa prudenza anche il claim che Jev non allucina. L’affermazione è vera in un senso ristretto e verificabile: l’uscita è vincolata all’insieme di opzioni che avete fornito, quindi non può contenere un valore inventato né un errore di tipo. Non significa che la risposta sia giusta. Un modello che sceglie billing quando la risposta corretta era technical ha sbagliato, e lo ha fatto in una forma che il vostro codice accetta senza protestare. La garanzia è sul tipo e va letta per quella.
Cosa ne pensiamo
La parte interessante di questo rilascio è la constatazione che lo regge, più del modello in sé, che resta chiuso e contingentato: quando la decisione che serve a un programma ha un insieme di risposte finito e noto, fare passare quella decisione attraverso la generazione di testo è un giro inutile che costa latenza, costa token e introduce un passo di parsing che può rompersi.
È un’osservazione che si può applicare subito, e nella maggior parte dei casi senza cambiare fornitore. Nei sistemi che vediamo, una quota rilevante delle chiamate a un LLM serve a ottenere una classificazione, un instradamento o un punteggio, cioè esattamente i casi in cui il vincolo sull’insieme delle risposte si può imporre. Il guadagno si misura in millisecondi e in codice di parsing che sparisce.
Le due cose da fare, in ordine. Primo, censire quante delle vostre chiamate a un modello producono in realtà una scelta fra alternative note e per quelle passare a decoding vincolato con lettura dei logprobs: funziona su modelli a pesi aperti, in casa, come abbiamo mostrato scrivendo di harness e sandbox. Secondo, misurare la calibrazione di quello che vi torna prima di appoggiarci sopra una soglia di automazione, perché è lì che si nasconde il rischio vero.
Su Jev restiamo in osservazione. Il modello è in early access, la documentazione è buona e l’idea è corretta; i numeri su latenza e calibrazione sono dichiarati dal fornitore e andranno verificati su carichi propri quando l’accesso sarà aperto.
Se avete flussi in cui un modello classifica, instrada o assegna punteggi, la cosa sensata prima di automatizzare è misurare costo, latenza e calibrazione su un vostro insieme etichettato. È il lavoro che facciamo nella consulenza sull’intelligenza artificiale, e non richiede di scegliere prima un fornitore.
Fonti
- TypeSafe AI, Introducing System One Models and Jev
- Documentazione TypeSafe, Quick start
- Documentazione TypeSafe, Primitives
- Documentazione TypeSafe, Confidence
- Documentazione TypeSafe, System One
- TypeSafe, workflow evals del fornitore
- The Register, TypeSafe AI debuts model for machines that plays Doom
- vLLM, structured outputs
- Guo et al., On Calibration of Modern Neural Networks
- Ovadia et al., Can You Trust Your Model’s Uncertainty?
- llama.cpp, grammatiche GBNF
- open-alternative-jev
- OpenJev
- vllm-jev-decison
- Von
- awesome-jev, lista curata dei progetti aperti
- Anatomia di un loop agentico
- Inferenza locale su DGX Spark