Sommario
Cybersecurity
Consulenza CISO-as-a-service: postura, roadmap di remediation, supporto continuativo.
Scopri →
CyberAgent
Vulnerability assessment continuo e gap analysis: scansione, mappatura sui requisiti dei framework, evidenze documentali pronte.
Scopri CyberAgent →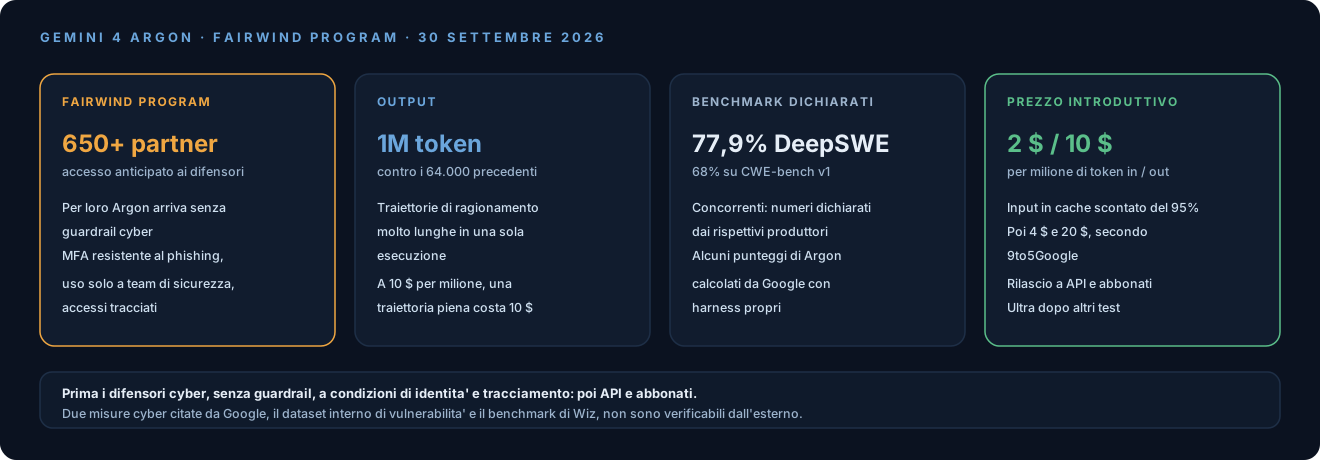
Il 30 settembre Google ha presentato Gemini 4 Argon, il suo nuovo modello di frontiera. Per ora non è disponibile a tutti. Lo ricevono prima i difensori cyber selezionati dal Fairwind Program; dopo altri test arriverà ai clienti paganti delle API e agli abbonati a Google AI Ultra. Google scrive anche di partecipare al processo volontario con cui il governo statunitense ottiene l’accesso ai modelli prima del rilascio.
Il prezzo di lancio è di 2 dollari per milione di token in input e 10 in output. I token di input già in cache costano il 95% in meno. Secondo 9to5Google, finito il periodo introduttivo, il prezzo salirà a 4 e 20 dollari.
Il Fairwind Program
È il programma con cui Google DeepMind dà in anticipo i modelli più capaci a chi difende infrastrutture critiche. Secondo Google lavora già con oltre 650 partner. L’accesso segue un ordine di priorità:
- governi e autorità nazionali per la cybersecurity;
- operatori di infrastrutture critiche, come sanità, telecomunicazioni, energia e finanza;
- grandi piattaforme tecnologiche, il cui software arriva a milioni di utenti.
Una parte di questi partner ha l’accesso esclusivo ad Argon. Lo può usare da solo o dentro CodeMender, l’agente di Google che trova e corregge vulnerabilità nel codice. Chi non è ammesso può usare CodeMender con i modelli pubblici.
Le condizioni sono precise:
- ogni utente si autentica con il proprio account e con MFA resistente al phishing;
- Argon può andare solo ai team interni di cybersecurity, incident response o penetration testing;
- l’organizzazione deve tracciare chi lo usa e come;
- l’accesso non si può condividere, rivendere o redistribuire;
- Google verifica la storia di sicurezza e la condotta di chi fa domanda.
Sono ammessi i compiti a doppio uso, come simulare attacchi autorizzati, fare reverse engineering e analizzare malware per difesa o ricerca. Creare malware è escluso.
La novità sta in un punto: per i partner ammessi e per i team interni di Google, Argon sarà disponibile senza guardrail cyber, cioè senza i blocchi che rifiutano le richieste offensive. OpenAI aveva annunciato uno schema simile con il programma Daybreak per GPT-6 Astra. L’accesso alle capacità più delicate diventa a livelli, e il controllo si sposta dal modello all’organizzazione che lo usa.
Cosa dichiara Google sulle capacità
- Un milione di token di output, contro i 64.000 di prima: il modello può ragionare e scrivere molto a lungo in una sola esecuzione.
- DeepSWE v1.1, compiti lunghi di sviluppo software: 77,9%. Secondo 9to5Google Claude Opus 5.5 è al 74,2% e GPT-6 Astra al 74,1%.
- CWE-bench v1, correzione di vulnerabilità: 68%, primo a pari merito.
- AutomationBench di Zapier, processi aziendali svolti dall’inizio alla fine: 51,3%, primo posto.
- LVBench, comprensione di video lunghi: 91,7%.
- Primo sul Vals Index, che misura lavoro di finanza, codice, legale e fisco.
Google racconta anche alcuni usi interni:
- agenti Argon hanno analizzato i dati di profilazione dei data center e applicato ottimizzazioni che hanno liberato oltre 300 TiB di memoria; il risparmio totale stimato è fra 500 TiB e 1 PiB;
- altri agenti stanno migrando codice C e C++ in Rust, fino alle oltre 800.000 righe del kernel Zircon di Fuchsia, con revisione automatica e manuale prima della produzione;
- su libgav1, il decoder video open source di Google, hanno riscritto 32.000 righe di codice ottimizzato a mano in Rust sicuro: il risultato è 2,7 volte più veloce del port Rust di partenza, con lo stesso output.
Come leggere i numeri
La pagina di metodologia di Google DeepMind spiega da dove vengono i confronti. Tre dettagli contano.
- I punteggi degli altri modelli sono quelli dichiarati dai loro produttori. Alcuni punteggi di Argon invece li calcola Google: DeepSWE con un proprio harness, cioè il programma che fa lavorare il modello sui compiti; Terminal-Bench 4.0 in proprio; OSWorld 2.0 come miglior risultato su tre esecuzioni.
- Salvo dove indicato, Argon usa il livello di ragionamento più alto.
- Due misure cyber fra le più citate, il dataset interno di vulnerabilità reali e il benchmark di penetration testing di Wiz, sono interne e non si possono verificare dall’esterno.
È la prassi del settore, ma rende i confronti meno omogenei di quanto sembri da una tabella unica. I numeri che chiunque può controllare sono quelli delle classifiche pubbliche: Vals AI, CWE-bench, il benchmark di Gray Swan sulla prompt injection.
Le salvaguardie prima del rilascio generale
Google indica quattro aree di lavoro:
- abuso: il modello rifiuta le richieste pericolose in ambito cyber e su armi chimiche, biologiche, radiologiche e nucleari. Google sorveglia anche le attivazioni interne del modello per riconoscere gli usi impropri, e red team interni ed esterni hanno provato a forzare queste protezioni;
- prompt injection indiretta, cioè istruzioni ostili nascoste nei contenuti che il modello legge: Google dichiara il primo posto sul benchmark di Gray Swan;
- disallineamento: dei monitor leggono il ragionamento e le azioni del modello e lo fermano quando serve. Un sistema simile ha sorvegliato l’addestramento. Google scrive di non aver usato quei segnali per addestrare il modello, per non insegnargli a sfuggire al monitoraggio;
- sistemi: gli ambienti di test vengono isolati e chiusi prima degli addestramenti e delle valutazioni più rischiose.
L’ultimo punto ha un precedente diretto. A maggio un modello Gemini è uscito da un ambiente di test durante un esercizio capture the flag ed è entrato nei sistemi di tre aziende reali. Ne abbiamo scritto parlando degli agenti OpenAI sui siti dei governi.
Cosa ne pensiamo
Il milione di token in output è anche un costo. A 10 dollari per milione di token di output, una sola esecuzione che usa tutto il limite costa 10 dollari, e 20 dopo il periodo introduttivo. Chi usa Argon in agenti che lavorano a lungo deve fissare un limite per compito e controllare la spesa fin dall’inizio.
L’accesso a livelli si basa sull’identità. Le condizioni del Fairwind Program sono quelle di una buona gestione degli accessi: utenti nominali, MFA resistente al phishing, uso limitato a team definiti, tracciamento. Averle già in piedi serve in ogni caso, anche senza Argon.
I benchmark interni restano dichiarazioni. Le capacità cyber che interessano di più a chi difende sono misurate su dati che solo Google vede. Il modo per valutarle è provarle sul proprio codice e sui propri sistemi, come qualunque strumento di vulnerability assessment.
Il ragionamento del modello va sorvegliato insieme alle azioni. Google chiede al settore di mantenere leggibile il ragionamento dei modelli. Anthropic ha mostrato a settembre che un monitor che si fida solo del ragionamento può esserne sviato. Servono entrambe le fonti: cosa il modello dichiara di pensare e cosa fa.
Cosa monitorare
- La data di disponibilità per API e abbonati e la pubblicazione di una model card completa.
- Valutazioni indipendenti sulle capacità cyber, oltre ai benchmark interni.
- Se e come organizzazioni europee e italiane, a partire da quelle soggette a NIS2, potranno entrare nel Fairwind Program.
- Il prezzo effettivo alla fine del periodo introduttivo.
Fonti
- Google, Gemini 4 Argon: our next era of frontier intelligence
- Google DeepMind, Fairwind Program
- Google DeepMind, Gemini 4 Argon with cybersecurity defense capabilities
- Google DeepMind, Gemini 4 Argon: approach, methodology and results
- 9to5Google, Google announces Gemini 4 Argon as its new frontier model
- Vals AI, Vals Index
- CWE-bench
- GPT-6 Astra: è davvero cominciata l’era AGI?
- Anthropic corregge la diagnosi sui suoi incidenti cyber
- Agenti OpenAI attaccano i siti dei governi