Sommario
Intelligenza Artificiale
Consulenza EU AI Act: classificazione dei sistemi, policy, governance AI, formazione.
Scopri →
DataGovern
Governance della documentazione di conformità: politiche, evidenze e registri tenuti insieme e aggiornati.
Scopri DataGovern →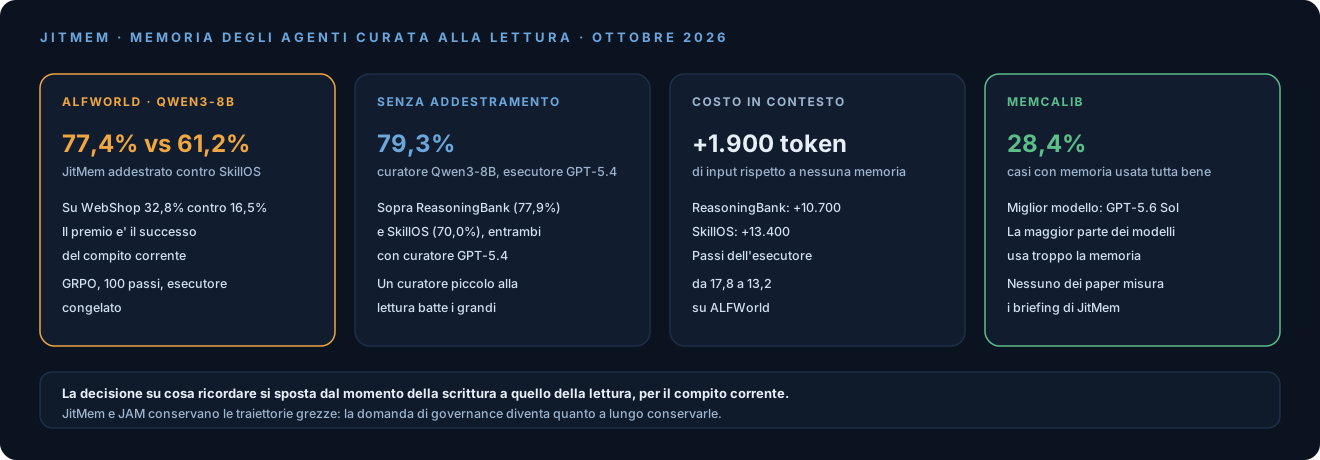
Un agente che ripete compiti simili ha bisogno di memoria. Oggi la soluzione più comune funziona così: quando un compito finisce, il sistema rilegge quello che l’agente ha fatto e lo riassume in un testo da conservare, per esempio una lezione appresa, una procedura o una skill. Nei compiti successivi recupera i riassunti più simili. La decisione su cosa ricordare viene presa quando si scrive la memoria.
Just-in-Time Memory, o JitMem, pubblicato su arXiv il 23 settembre, sposta quella decisione a quando si legge. È uno di quattro lavori usciti nelle ultime due settimane sullo stesso problema, messi a confronto dalla newsletter LLM Watch.
Il limite dei riassunti scritti in anticipo
Gli autori indicano due problemi. Il primo è che ciò che il riassunto scarta è perso per sempre, anche per i compiti futuri che ne avrebbero avuto bisogno. Il secondo è che un riassunto fisso deve servire a tutto, mentre una stessa esperienza può insegnare cose diverse. Nell’esempio del paper, la stessa sequenza di azioni in una casa simulata può servire a un compito per ricordare di scaldare un oggetto prima di metterlo in frigo, e a un altro per ricordare di verificare dove si trova un oggetto prima di spostarlo. Quale lezione conta dipende da un compito che, quando si scrive la memoria, non esiste ancora.
C’è anche un problema di addestramento. Se si vuole insegnare a un modello a scrivere buoni riassunti, il premio arriva solo quando un compito futuro li usa, magari molto dopo. SkillOS, il lavoro più vicino, deve raggruppare compiti simili per creare quel segnale.
Come funziona JitMem
Il sistema ha quattro parti.
- La memoria conserva le esecuzioni complete, senza riassunti: la descrizione del compito e ogni passo dell’agente. Entra solo un’esecuzione che il modello giudica riuscita.
- La ricerca usa BM25, un classico algoritmo di ricerca per parole chiave, sulla sola descrizione dei compiti e restituisce le tre esecuzioni più vicine.
- Il curatore, un Qwen3-8B, legge il nuovo compito e le tre esecuzioni e scrive un breve testo: quali esperienze contano, cosa ha funzionato, cosa fare in questo caso.
- L’esecutore, un modello che non viene modificato, riceve quel testo all’inizio del prompt e svolge il compito. Non vede mai le esecuzioni originali, e il testo viene scartato dopo l’uso.
Per l’addestramento il vantaggio è diretto: il testo del curatore si usa subito, sullo stesso compito, quindi il premio è il successo del compito stesso. Il curatore viene addestrato con GRPO, un metodo di reinforcement learning, in 100 passi e senza raggruppare compiti. L’esecutore resta invariato.
Cosa misura
Con lo stesso modello di base, Qwen3-8B, JitMem addestrato risolve il 77,4% dei compiti su ALFWorld contro il 61,2% di SkillOS e il 32,8% su WebShop contro il 16,5%. ALFWorld e WebShop sono ambienti di prova standard: una casa simulata e un negozio online.
Il risultato più chiaro arriva senza addestramento. Con GPT-5.4 come esecutore su ALFWorld, JitMem con un curatore Qwen3-8B non addestrato arriva al 79,3%. Supera ReasoningBank (77,9%) e SkillOS (70,0%), che usano GPT-5.4, un modello molto più grande, per scrivere la memoria. Un curatore piccolo che lavora al momento della lettura fa meglio di curatori grandi che lavorano al momento della scrittura.
Gli autori hanno anche tolto una scelta alla volta per vedere quanto pesa:
- se il curatore non vede il compito corrente e fa un riassunto generico, si perdono fino a 11,4 punti su ALFWorld;
- se le esecuzioni vengono riassunte prima di salvarle, il curatore non addestrato perde da 6,8 a 8,2 punti su WebShop;
- salvare anche le esecuzioni fallite, con l’indicazione dell’errore, dà risultati peggiori che salvare solo i successi;
- se il curatore addestrato lavora senza esecuzioni da leggere, torna al livello di quello non addestrato o scende sotto, fino a 15,2 punti in meno. Per gli autori è il segno che l’addestramento gli ha insegnato a usare la memoria, non a dare consigli generici.
Due risultati riguardano i costi. Un curatore addestrato insieme a Qwen3-8B funziona anche con GPT-5.4: 86,7% su ALFWorld, a 1,4 punti da uno addestrato direttamente con GPT-5.4. E con GPT-5.4 su ALFWorld JitMem aggiunge solo 1.900 token al prompt, contro 10.700 di ReasoningBank e 13.400 di SkillOS. L’agente finisce il compito in 13,2 passi invece di 17,8.
Il metodo non aiuta sempre. Su τ²-bench, che simula l’assistenza clienti, migliora i risultati nel dominio delle telecomunicazioni (72,6% contro 61,6% di ReasoningBank, entrambi con GPT-5.4). Nei domini compagnie aeree e retail nessun metodo di memoria fa meglio dell’agente senza memoria. Secondo gli autori, la memoria curata alla lettura serve soprattutto quando bisogna ricavare indicazioni su come procedere, meno quando basta ritrovare un fatto.
Tre lavori vicini
JAM (Just-In-Time Agent Memory, Beijing Academy of Artificial Intelligence con Peking University e Hong Kong Polytechnic University) fa la stessa diagnosi. Anche JAM conserva lo storico completo, ma al momento della domanda fa lavorare un agente di ricerca, un Qwen3.5-4B. L’archivio è organizzato in cartelle, con un breve promemoria per ogni sessione e un README per ogni cartella. L’agente apre cartelle, cerca e legge file finché ha abbastanza elementi, poi scrive un contesto che cita le fonti. Su LoCoMo, un benchmark di conversazioni lunghe, arriva a 52,09 di F1 contro 46,13 di MemAgent-14B e 32,10 di Mem0, in 13,81 secondi per domanda contro 58,08 di MemAgent. Un risultato corregge la posizione più radicale: con un archivio piatto, senza cartelle e promemoria, l’F1 scende a 49,06 e i tempi salgono a 17,11 secondi. Conviene quindi tenere i dati grezzi insieme a un indice che aiuti a orientarsi.
Designer-RSI (arXiv 2609.22086, Adobe e Brown University) va nella direzione opposta, con buoni risultati. È un agente di grafica che usa equivalenti di Photoshop, Illustrator e InDesign attraverso oltre 230 strumenti. La sua memoria è fatta di skill scritte in anticipo, cioè procedure in file SKILL.md. Ogni skill nuova o riscritta deve passare un test: viene rieseguita sugli stessi casi e confrontata con la versione in uso, o con l’agente senza skill. Entra solo se non peggiora nessun caso e ne migliora almeno uno. In cinque cicli su 1.406 richieste il test ha respinto 100 riscritture su 231 e 67 nuove skill su 136. Con Claude-Sonnet-4 la riuscita su GenEval2 sale dal 72,7% al 99,3%. Le 76 skill ricavate dalla sola documentazione dei prodotti, scritte prima di vedere compiti reali, non hanno invece migliorato nulla (68,62 contro 69,08 di completezza). La differenza con JitMem sta in cosa si ricorda: Designer-RSI conserva procedure che si ripetono, JitMem e JAM esperienze e fatti la cui utilità dipende dalla domanda.
MemCalib (arXiv 2609.24259, University of Science and Technology of China, Qwen di Alibaba e Fudan University) verifica un’ipotesi che gli altri tre danno per scontata: che il modello usi bene la memoria che riceve. Divide la memoria in singole affermazioni e indica per ciascuna se andava ignorata, usata come appoggio o usata per decidere la risposta. Poi un modello giudice controlla come è stata usata davvero; il giudice concorda con un annotatore umano nel 96,7% dei casi. Il miglior modello provato, GPT-5.6 Sol, si ferma a 46,25 di Sample Calibration Score e usa bene tutte le affermazioni solo nel 28,40% dei casi. La maggior parte dei modelli si fida troppo della memoria e Qwen3-8B troppo poco. Un modello più grande non è necessariamente migliore. Il metodo di addestramento proposto, MemCalib-RL, porta Qwen3-8B a 79,54.
Cosa ne pensiamo
Provarlo costa poco. Per un agente che ripete compiti simili bastano quattro passi: salvare le esecuzioni complete, tenere solo quelle riuscite, recuperarne tre con una ricerca per parole chiave sulla descrizione del compito e aggiungere una chiamata a un modello che legge compito ed esecuzioni e scrive un breve briefing. Nel paper buona parte del guadagno arriva già senza addestramento. L’addestramento aggiunge altro se si hanno compiti con un esito verificabile.
Dipende da cosa si vuole ricordare. Per procedure che si ripetono uguali con molti clienti, skill scritte una volta e ammesse solo se non peggiorano nulla sono una scelta sensata, purché vengano riscritte sui fallimenti reali e non solo sulla documentazione. Per storici lunghi fra molte sessioni il riferimento è JAM, che però richiede qualche secondo per domanda. Per esperienze la cui utilità dipende dal compito, nei confronti misurati da JitMem la memoria curata alla lettura dà i risultati migliori.
Conservare tutto pone una domanda di governance. JitMem e JAM tengono le interazioni complete invece dei riassunti. La domanda passa da cosa il sistema ha deciso di ricordare a quanto a lungo conserva quello che ha visto. In azienda quelle esecuzioni contengono dati di clienti, documenti e a volte credenziali passate dagli strumenti. Se ci sono dati personali valgono le regole del GDPR su conservazione limitata e minimizzazione: servono un periodo di conservazione definito e un filtro su cosa entra in memoria. I due paper non affrontano il tema, che avevamo toccato nella seconda parte della serie sull’agentic loop.
Resta una domanda aperta. JitMem misura se il testo del curatore fa riuscire più compiti, non se l’esecutore dà a ogni riga il peso giusto. MemCalib misura proprio quel peso, ma su memorie preparate per il test, non su testi scritti da un curatore. Valutare i briefing di JitMem con il metodo di MemCalib direbbe se la memoria curata alla lettura aiuta anche il modello a usarla bene.
Fonti
- Zhou et al., Just-in-Time Memory: Learning to Curate Task-Adaptive Memory for LLM Agents
- Yan et al., Just-In-Time Agent Memory with Runtime Agentic Research
- Du et al., Designer-RSI: Evolving Procedural Memory from User Traffic for Agentic Graphic Design
- Cao et al., MemCalib: Benchmarking and Optimizing Memory Use in LLM Agents
- LLM Watch, Just-in-Time Memory
- Agentic loop (2): contesto, pattern e multi-agente