Articolo
Il 6 ottobre Mistral AI ha presentato Mistral Large 4, il suo nuovo modello di punta. Per ora è disponibile in anteprima pubblica tramite le API di Mistral Studio. I pesi sono annunciati entro la fine di ottobre, insieme a dettagli su architettura e post-training. Secondo Mistral supera nettamente i modelli open weight sviluppati negli Stati Uniti e in Europa.
Architettura
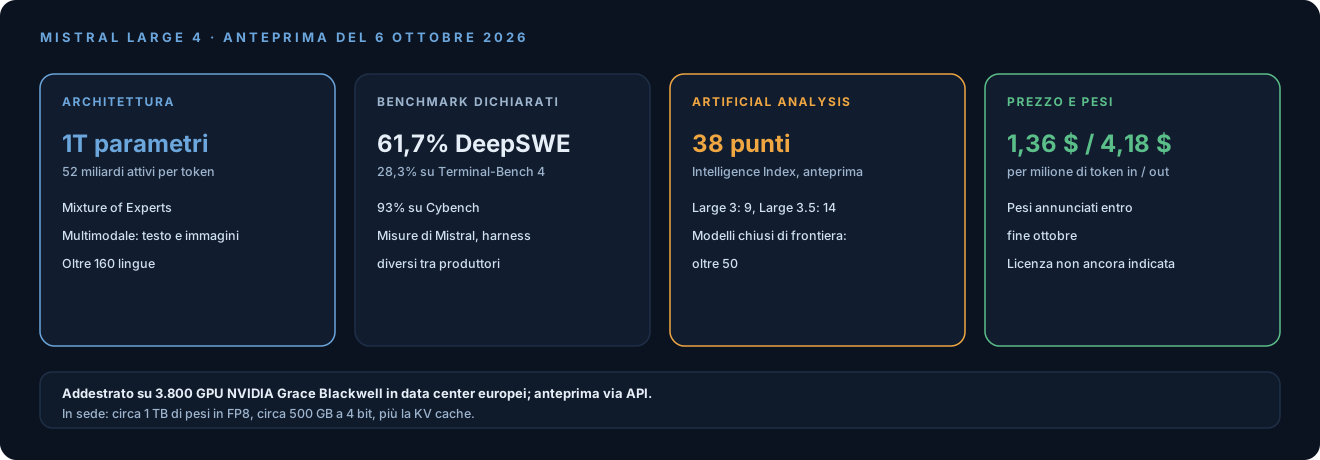
- Mixture of Experts con un trilione di parametri complessivi, di cui 52 miliardi attivi per ogni token.
- Un solo modello per risposte dirette e per il ragionamento.
- Multimodale in ingresso: testo e immagini, con output testuale.
- Oltre 160 lingue, comprese tutte le lingue ufficiali dell’Unione europea.
- Addestrato da zero su 3.800 GPU NVIDIA Grace Blackwell nei data center europei di Mistral.
Mistral annuncia che Large 4 farà da base a una nuova generazione di modelli specializzati e ottimizzati.
I benchmark dichiarati
I numeri pubblicati da Mistral riguardano soprattutto programmazione agentica, automazione e sicurezza:
- 61,7% su DeepSWE v1.1 e 28,3% su Terminal-Bench 4;
- 59,9% su AutomationBench;
- 93% delle prove di Cybench e un posto fra i primi cinque modelli dell’AA Cyber Index, con l’82% nella prova di riproduzione delle vulnerabilità;
- 93,3% degli attacchi respinti sul benchmark B3.
Sono misure del produttore e i confronti con altri modelli valgono solo a parità di harness e condizioni. Su DeepSWE, per esempio, Google ha dichiarato il 77,9% per Gemini 4 Argon: i due numeri vengono da due produttori diversi.
Artificial Analysis, che valuta i modelli in modo indipendente, assegna all’anteprima 38 punti nel suo Intelligence Index. Secondo t3n Large 3 ne aveva 9 e Large 3.5 14; con 38 punti Large 4 è al livello di GPT-6 Luna e DeepSeek V4.1 Flash, mentre Claude Opus 5.5, GPT-6 Astra e Gemini 4 Argon superano i 50. Artificial Analysis segnala anche che il modello è molto prolisso: durante la valutazione ha prodotto 200 milioni di token in output (la mediana è di 81 milioni). Questo pesa sul costo effettivo di ogni compito.
Prezzo e disponibilità
- 1,36 dollari per milione di token in input e 4,18 in output; l’input in cache costa il 90% in meno secondo Artificial Analysis.
- Finestra di contesto dell’anteprima: 524.000 token, secondo Artificial Analysis.
- Licenza: Mistral non l’ha ancora indicata. Finché i pesi non sono pubblici, Artificial Analysis classifica il modello come proprietario.
- Mistral scrive che il modello potrà essere eseguito su cloud privato o on-premise, per chi ha bisogno di un’AI sovrana e verificabile nelle operazioni di sicurezza.
Cosa serve per eseguirlo in sede
In un Mixture of Experts i parametri attivi riducono il calcolo per ogni token, la memoria no: in memoria deve stare l’intero modello. Con un trilione di parametri servono circa 1 TB per i soli pesi in FP8 e circa 500 GB con una quantizzazione a 4 bit, a cui si aggiungono la KV cache e i margini del motore di inferenza.
Servono quindi un server con più GPU di fascia data center e diverse centinaia di GB di memoria complessiva. Una workstation come quelle con NVIDIA GB10, con 128 GB di memoria unificata, è dimensionata per modelli molto più piccoli. I modelli specializzati che Mistral costruirà su Large 4 potranno avere requisiti diversi.
Cosa ne pensiamo
Un modello open weight di questa scala, addestrato e servito in Europa, amplia le scelte di chi deve tenere dati e inferenza sotto la giurisdizione europea, in un panorama dei pesi aperti guidato finora da laboratori cinesi e statunitensi. Restano aperte due questioni: la licenza (da cui dipendono gli usi commerciali consentiti) e la distanza dai modelli chiusi di frontiera nell’indice di Artificial Analysis.
Cosa monitorare
- La pubblicazione dei pesi e i termini della licenza.
- Valutazioni indipendenti sui pesi pubblicati, oltre ai benchmark di Mistral.
- La finestra di contesto della versione definitiva.
- I modelli specializzati derivati da Large 4 e i loro requisiti.