Sommario
Cybersecurity
Consulenza CISO-as-a-service: postura, roadmap di remediation, supporto continuativo.
Scopri →
Servizi & Sistemi Linux
Domini, hosting, PEC, infrastruttura email, servizi di rete e sistemi Linux. Assistenza e gestione dell'infrastruttura Open Source.
Scopri →
CyberAgent
Vulnerability assessment continuo e gap analysis: scansione, mappatura sui requisiti dei framework, evidenze documentali pronte.
Scopri CyberAgent →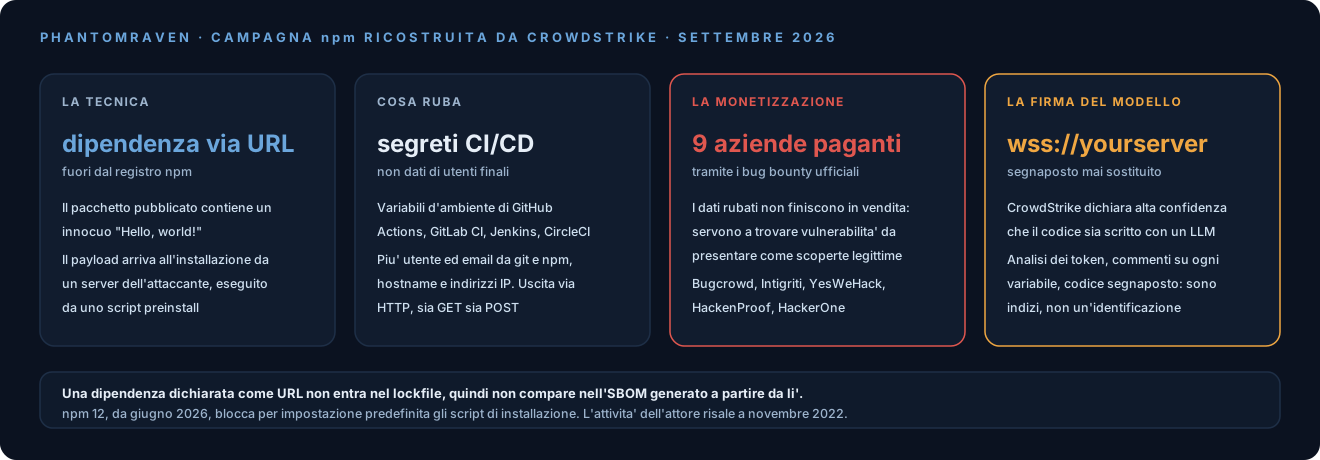
CrowdStrike Counter Adversary Operations ha pubblicato l’analisi di PhantomRaven, un information stealer in JavaScript distribuito attraverso npm. La campagna era già stata segnalata da Koi Security e DCODX alla fine di ottobre 2025 e ripresa poi da altri ricercatori su ondate successive.
La parte nuova non è il malware. È come viene monetizzato: l’attaccante usa i segreti rubati per trovare vulnerabilità nelle aziende colpite, poi porta quelle vulnerabilità ai programmi ufficiali di bug bounty e incassa il premio. CrowdStrike scrive che ha riscosso da almeno nove entità fra tecnologia, retail e ospitalità.
La tecnica: la dipendenza non sta nel registro
Il meccanismo è la parte che conviene capire bene, perché spiega perché gli strumenti di analisi non lo vedevano.
I pacchetti pubblicati su npm sono typosquatting di nomi plausibili e contengono codice innocuo: CrowdStrike parla di un semplice script Hello, world!. Chi guardasse il contenuto pubblicato non troverebbe nulla. Il trucco sta nel package.json, dove le dipendenze sono dichiarate come URL HTTP invece che come riferimenti al registro npm. All’installazione npm va a prendere quella dipendenza da un server dell’attaccante, e da lì arriva il payload vero.
A completare la catena c’è uno script preinstall, che si esegue da solo durante l’installazione senza che nessuno lo lanci.
Due pacchetti nominati nell’analisi sono transform-jsbi-to-bigint, pubblicato dall’utenza jpdhellonpm1, e sort-imports-es6-autofix, pubblicato da jpd15.
Il punto che ci interessa di più è una conseguenza che l’analisi non sottolinea ma che vale per chiunque stia costruendo la propria catena di conformità: una dipendenza dichiarata come URL non finisce nel lockfile come pacchetto del registro, quindi non entra nell’SBOM generato a partire da lì. L’inventario delle dipendenze, che dall’11 settembre il Cyber Resilience Act rende il perno di tutto e che dal 2027 sarà obbligatorio nella documentazione tecnica, in questo caso mostra un pacchetto pulito con una dipendenza che non sa descrivere. Non è un difetto dell’SBOM: è un limite di cosa un SBOM misura, e va conosciuto prima di trattarlo come una garanzia.
Cosa ruba
L’elenco è quello tipico di chi punta agli ambienti di sviluppo e di build, non agli utenti finali: tipo di sistema operativo, architettura, hostname, indirizzi IP, dettagli dei processi, versione di NodeJS, nome utente ed email presi dalle configurazioni git e npm, e soprattutto le variabili d’ambiente CI/CD di GitHub Actions, GitLab CI, Jenkins e CircleCI.
Per l’indirizzo IP pubblico il malware interroga api64.ipify.org. L’esfiltrazione avviene via HTTP, con richieste sia GET sia POST e con un canale WebSocket alternativo rimasto incompleto.
Su quelle variabili d’ambiente si gioca tutto il resto. Un token di pipeline è la chiave che apre il registro, il repository e spesso gli ambienti di distribuzione: è la stessa lezione della catena PyPI dentro le valutazioni di Anthropic, dove a perdere le credenziali fu lo scanner di un vendor di sicurezza.
La monetizzazione, che è la parte inedita
Qui la storia cambia genere. L’attaccante non rivende i dati rubati: CrowdStrike annota di non averli visti comparire sui mercati dei log, e ne ricava che lo stealer serve solo a individuare occasioni di bug bounty.
Il ciclo è questo. I segreti rubati aprono l’accesso agli asset dell’azienda. Dentro quegli asset l’attaccante cerca vulnerabilità. Le vulnerabilità trovate vengono presentate come scoperte legittime ai programmi di bug bounty, sulle piattaforme che l’analisi elenca: Bugcrowd, Intigriti, YesWeHack, HackenProof e HackerOne. Almeno nove aziende hanno pagato.
Vale la pena fermarsi su cosa significa. Un programma di bug bounty esiste per comprare informazione su vulnerabilità da chi la trova in modo legittimo, e funziona perché il pagamento rende la divulgazione più conveniente dello sfruttamento. Qui quel meccanismo viene usato come canale di incasso di un accesso ottenuto rubando: l’istituzione difensiva finisce per pagare il ricavo dell’attacco, e lo fa senza poterlo distinguere da una segnalazione onesta, perché la vulnerabilità segnalata è reale.
È lo stesso schema su cui ci eravamo fermati a proposito degli incidenti di Anthropic, dove la pratica difensiva della scansione dei pacchetti nuovi era diventata il vettore. Qui il passo in più è che la difesa diventa la fonte di ricavo e non soltanto il tramite.
Dal lato di chi gestisce un programma, la conseguenza pratica è che la provenienza dell’accesso diventa una domanda da porre. Una segnalazione valida non dice nulla su come il ricercatore sia arrivato al sistema, e le regole di ingaggio di molti programmi non chiedono di dimostrarlo.
La firma del modello, da leggere con cautela
CrowdStrike afferma con alta confidenza che il codice è stato scritto con l’aiuto di un modello linguistico. Le prove portate sono tre: l’analisi statistica sui pattern dei token, i commenti ridondanti su ogni variabile globale e su ogni funzione, il codice segnaposto rimasto nel prodotto finito. L’esempio più leggibile è il canale WebSocket di riserva, che punta a wss://yourserver.com/socket, cioè un indirizzo di esempio mai sostituito. Viene notata anche una scelta di progetto insolita, cioè esfiltrare gli stessi dati sia con POST sia con GET.
Su questo tipo di conclusione vale la prudenza che abbiamo già applicato altrove. Stabilire l’autore di un testo a partire da come è scritto è un’inferenza, non una misura: i commenti ridondanti e i segnaposto dimenticati esistevano molto prima dei modelli, e l’analisi statistica dei token dà una probabilità, non un’identificazione. L’affermazione è dichiarata da CrowdStrike con il suo livello di confidenza, ed è corretto riportarla così, con quel livello attaccato.
Quello che invece si può osservare senza inferenze è che il codice funziona e che la campagna dura da anni: l’attività risale a novembre 2022.
Cosa è già cambiato e cosa tocca a voi
Un pezzo della difesa è arrivato dal registro. npm 12, uscito a giugno 2026, blocca per impostazione predefinita gli script che si eseguono durante l’installazione, avvisa e chiede un’approvazione esplicita. Chi è aggiornato ha già disinnescato la parte che si attiva da sola.
Il resto sono decisioni vostre, e CrowdStrike ne indica alcune che vale la pena riportare per quello che sono, cioè misure ordinarie che quasi nessuno applica per intero.
- Eseguire le installazioni con
--ignore-scriptscome regola, non come eccezione, e riabilitare gli script solo per i pacchetti che li richiedono davvero. - Interporre un registro privato fra la propria pipeline e npm pubblico, che è anche l’unico punto dove si può applicare una politica su cosa entra.
- Tenere aggiornato npm, perché in questo caso la mitigazione è già nel client.
- Trattare la formazione sulla dependency confusion come materia operativa e non come slide.
Ne aggiungiamo due che nascono dalla tecnica specifica. Vietare le dipendenze dichiarate come URL nei manifest, o quantomeno segnalarle in revisione: sono rare in un progetto sano e sono esattamente ciò che questa campagna usa. E trattare le variabili d’ambiente della pipeline come segreti con scadenza, perché è quello che l’attaccante porta via e che gli apre tutto il resto.
Cosa ne pensiamo
La lezione tecnica sta nel punto cieco. Gli strumenti che guardano il contenuto di un pacchetto pubblicato non vedono niente, perché il pacchetto è pulito; l’SBOM costruito dal lockfile non descrive la dipendenza remota; il codice malevolo arriva solo al momento dell’installazione, da un server che l’attaccante controlla e può spegnere prima di un’analisi. Tre livelli di verifica che guardano nel posto sbagliato, non perché siano mal fatti ma perché misurano l’artefatto e non il comportamento dell’installazione.
Per chi si occupa di cybersecurity questa è la ragione per cui l’inventario statico e l’osservazione a runtime non sono alternative. Il primo dice cosa avreste dovuto installare, il secondo cosa è successo davvero quando l’avete installato. La campagna vive nello spazio fra le due cose.
La lezione sugli incentivi è più scomoda e riguarda chi gestisce un programma di bug bounty. Un premio pagato per una vulnerabilità reale, trovata con un accesso rubato, è un pagamento che finanzia l’intrusione che lo ha reso possibile. Distinguere il caso richiede di chiedere come si è arrivati al sistema, non solo se il difetto esiste, e di avere una regola su cosa fare quando la risposta non convince.
Sul fatto che il codice sia scritto da un modello, la nostra lettura è che cambi poco sul piano difensivo e parecchio sul piano del volume. Un malware con commenti verbosi e segnaposto dimenticati non è più pericoloso di uno scritto a mano. È però più veloce da produrre, e duecento pacchetti pubblicati in ondate successive sono un costo di produzione che prima non era alla portata di un attore singolo.
Fonti
- CrowdStrike, PhantomRaven: LLM-generated Information Stealer for Bug Bounty Hunting
- The Hacker News, Claimed Bug Bounty Hunter Likely Used LLM to Build PhantomRaven npm Stealer
- Endor Labs, The Return of PhantomRaven
- Anthropic corregge la diagnosi sui suoi incidenti cyber
- Cyber Resilience Act: le 24 ore partono oggi
- Cyber Resilience Act: SBOM e reporting vulnerabilità in arrivo