Sommario
Intelligenza Artificiale
Consulenza EU AI Act: classificazione dei sistemi, policy, governance AI, formazione.
Scopri →
DataGovern
Governance della documentazione di conformità: politiche, evidenze e registri tenuti insieme e aggiornati.
Scopri DataGovern →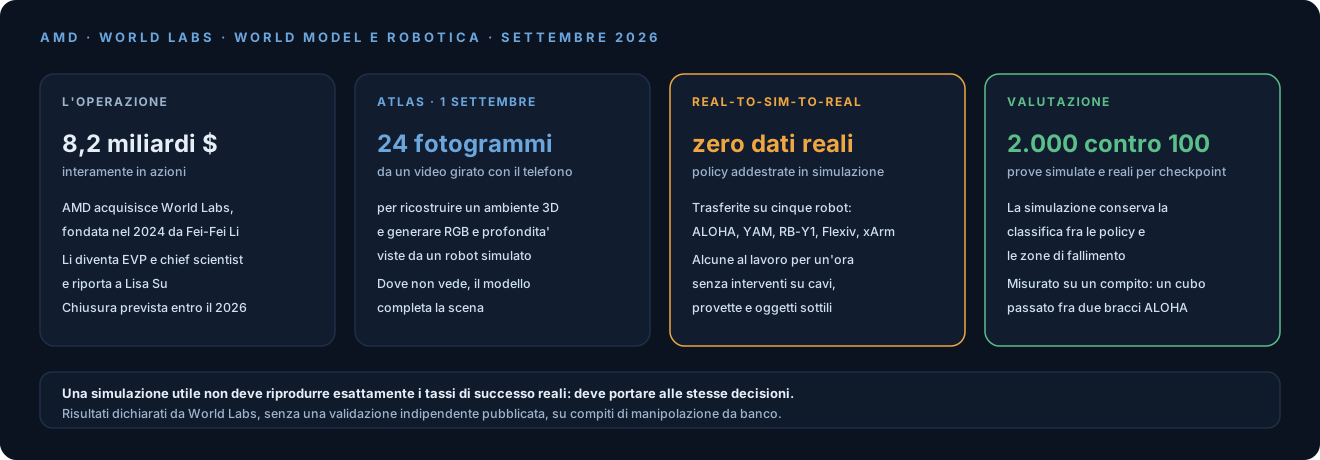
Il 28 settembre AMD ha annunciato un accordo definitivo per acquisire World Labs, il laboratorio fondato all’inizio del 2024 da Fei-Fei Li, il cui gruppo a Stanford ha creato ImageNet, insieme a Justin Johnson, Christoph Lassner e Ben Mildenhall. L’operazione vale circa 8,2 miliardi di dollari, interamente in azioni, e dovrebbe chiudersi entro la fine del 2026, se arriveranno le autorizzazioni. Li entra in AMD come executive vice president e chief scientist, alle dirette dipendenze di Lisa Su, e il team continuerà a lavorare sulla ricerca sui modelli.
World Labs costruisce world model: modelli che generano, ricostruiscono e simulano ambienti 3D interattivi a partire da testo, immagini e video, e che l’azienda usa anche per addestrare e valutare robot. Il problema a cui questa categoria di modelli prova a rispondere ha quasi quarant’anni.
Il paradosso che i modelli linguistici non hanno risolto
Nel 1988, in Mind Children, il ricercatore di robotica Hans Moravec scriveva che “it is comparatively easy to make computers exhibit adult level performance on intelligence tests or playing checkers, and difficult or impossible to give them the skills of a one-year-old when it comes to perception and mobility”: è relativamente facile ottenere da un computer prestazioni da adulto nei test di intelligenza o a dama, e difficile o impossibile dargli le capacità di percezione e di movimento di un bambino di un anno.
I modelli che oggi scrivono codice e risolvono problemi matematici hanno spostato molto la prima metà della frase e poco la seconda. La ragione è in buona parte nei dati. Un modello linguistico impara da un corpus di testo che esisteva già, prodotto da decenni di scrittura umana. Per l’interazione fisica un corpus equivalente non c’è: ogni esempio utile costa tempo macchina su un robot vero, oggetti da rimettere a posto, guasti da recuperare. Secondo World Labs nemmeno il video disponibile in rete copre in modo sistematico configurazioni, materiali, tipi di robot e condizioni di errore.
Il secondo collo di bottiglia è la valutazione. Per sapere se una policy di controllo funziona bisogna provarla su hardware, e per World Labs è questo a rendere lo sviluppo robotico più lento di quello dei modelli linguistici di ordini di grandezza. I compiti che l’azienda usa nelle proprie dimostrazioni danno la misura del problema: infilare l’estremità di un cavo elastico in un foro, sfilare una matita alla volta da un contenitore affollato, riempire una scatola con due bracci. Sono gesti che una persona esegue senza pensarci e che per un robot restano difficili da generalizzare.
Cosa si intende per world model
Il termine è usato in modo largo. World Labs ha proposto a giugno una tassonomia funzionale che distingue tre cose diverse:
- il renderer produce osservazioni, cioè pixel destinati a occhi umani, e si misura sulla fedeltà visiva: è il caso dei modelli video e dei sistemi interattivi come Genie 3 di Google DeepMind;
- il simulatore produce stato, cioè una rappresentazione del mondo fedele nella geometria, nella fisica e nella dinamica, su cui possono calcolare sia le persone sia i programmi;
- il planner produce azioni: data un’osservazione e un obiettivo, decide cosa fare dopo, come i modelli vision-language-action.
World Labs sostiene che il simulatore sia il meno discusso dei tre e il più importante, perché è il luogo in cui un agente può agire, imparare ed essere valutato. L’idea di un modello interno che anticipa le conseguenze delle azioni ha una storia lunga: la tassonomia stessa la fa risalire ai “small-scale models” della realtà proposti da Kenneth Craik nel 1943. Sui sistemi anticipatori, con bracci robotici e visione attiva, lavorava il progetto europeo MindRACES fra il 2004 e il 2007, a cui abbiamo partecipato sviluppando il framework AKIRA.
Da NeRF ai Gaussian splat
Ricostruire una scena 3D da fotografie è passato negli ultimi anni per due tappe. Nel 2020 NeRF, di cui Mildenhall è primo autore, ha mostrato che una rete neurale può rappresentare una scena come una funzione che restituisce densità e colore per ogni punto e direzione, da cui ottenere con il volume rendering immagini da punti di vista mai fotografati, a partire da decine di foto con posizione della fotocamera nota. Nel 2023 il 3D Gaussian Splatting di Kerbl e colleghi ha sostituito la rete con milioni di ellissoidi 3D, ciascuno con posizione, forma, colore e opacità, che si rasterizzano in tempo reale. È la rappresentazione che usano Marble e Atlas.
Un Gaussian splat descrive bene come appare una scena e poco come si comporta: non contiene masse, attriti né superfici solide. Per questo Marble esporta anche mesh di collisione, e per questo nel metodo real-to-sim-to-real la parte difficile è la dinamica. È la stessa distinzione fra renderer e simulatore, vista dal lato dei formati.
Cosa ha costruito World Labs
In meno di tre anni l’azienda ha messo in fila questi passaggi:
- 12 novembre 2025: Marble, modello multimodale che genera mondi 3D esplorabili ed esporta 3D Gaussian splat e mesh di collisione;
- 21 gennaio 2026: una World API pubblica per generare mondi 3D da testo, immagini e video;
- 21 luglio 2026: l’acquisizione di SceniX, società di robotica e simulazione che sviluppava un motore real-to-sim-to-real;
- 1 settembre 2026: Atlas, il nuovo world model.
Atlas è descritto come un modello omni addestrato da zero su testo, immagini, video e 3D, con un’architettura autoregressive diffusion transformer. Tutti gli input entrano in un contesto spaziale comune in cui ogni immagine ha una posizione nello spazio 3D, e il modello genera ciò che viene dopo restando coerente con quello che ha visto. Secondo World Labs ricostruisce una scena da una a oltre cento immagini, in modo fedele già con due o tre; produce video fino a un minuto a 1440p; restituisce output 3D espliciti come nuvole di punti e Gaussian splat. Per la robotica l’azienda mostra due ambienti estesi ricostruiti da un video girato con il telefono, 24 fotogrammi ciascuno, in cui Atlas genera le immagini RGB e la profondità che vedrebbero le telecamere di un robot simulato mentre si muove.
Sono risultati dichiarati dall’azienda, pubblicati come post tecnici con video dimostrativi.
Real-to-sim-to-real, passo per passo
Addestrare in simulazione e trasferire sul robot reale non è un’idea nuova. La tecnica più nota è la domain randomization: si costruisce a mano un simulatore e se ne variano a caso colori, luci, masse e attriti, finché la policy impara a ignorare le differenze con la realtà. Con una versione automatica di questo approccio OpenAI aveva addestrato nel 2019 una mano robotica a risolvere il cubo di Rubik. Il limite è il costo di modellare a mano ogni ambiente e ogni oggetto.
Il metodo che World Labs ha presentato il 28 luglio con SceniX parte invece dalla ripresa di un compito reale e usa un modello generativo per ricostruirlo. In sintesi:
- Acquisizione: si riprendono il robot, i sensori, l’ambiente, gli oggetti e alcune dimostrazioni del compito.
- Ricostruzione: il compito diventa un mondo interattivo che conserva l’aspetto, la geometria e la dinamica. Dove forma, peso o attrito degli oggetti sono incerti, e dove cavi e imballaggi si deformano, il sistema combina rappresentazioni diverse a seconda di cosa conta per quel compito.
- Validazione: la stessa sequenza di azioni viene eseguita in anello aperto in simulazione e nella realtà, confrontando osservazioni, movimenti degli oggetti ed esiti.
- Variazione: si modificano in modo sistematico aspetto, configurazione degli oggetti, disordine, parametri fisici, stato del robot e punto di vista delle telecamere.
- Addestramento: le policy imparano in simulazione, si cercano i punti in cui falliscono e si genera l’esperienza che serve a correggerle.
- Valutazione: i checkpoint vengono selezionati in simulazione e sull’hardware arrivano solo i più promettenti.
I risultati dichiarati sono due. Policy addestrate senza alcun dato reale sono state trasferite direttamente su cinque piattaforme diverse (ALOHA, YAM, RB-Y1, Flexiv e xArm), e diverse hanno lavorato un’ora di fila senza interventi su cavi, provette e oggetti sottili in mezzo al disordine. La valutazione è stata misurata su un compito, il passaggio di un cubo fra due bracci ALOHA: ogni checkpoint è stato provato su 2.000 prove simulate e 100 prove reali, metà dentro e metà fuori dalla distribuzione di addestramento, e la simulazione ha conservato la classifica fra le policy e le zone di successo e di fallimento.
Il criterio che World Labs mette per iscritto vale anche per chi non usa i suoi strumenti: una simulazione utile non deve riprodurre esattamente i tassi di successo reali, deve portare alle stesse decisioni della realtà, cioè quale policy è migliore, dove fallisce e se un miglioramento in addestramento si trasferisce all’hardware.
I limiti sono quelli di qualunque risultato non ancora replicato: i dati sono dell’azienda, non c’è una validazione indipendente pubblicata, la valutazione è mostrata su un solo compito e i compiti sono manipolazioni da banco, non una linea di produzione completa. La stessa tassonomia di World Labs aggiunge un rischio specifico dei simulatori generativi: una geometria generata può “look correct while containing self-intersections or wrong scale that produce nonsensical physics”, cioè sembrare corretta e contenere compenetrazioni o scale sbagliate che producono fisica priva di senso.
Perché lo compra chi fa chip
AMD motiva l’operazione con i carichi di lavoro. Il comunicato spiega che, mentre l’AI si estende a ragionamento, robotica, simulazione e physical AI, le richieste all’infrastruttura di calcolo diventano più varie, e che la competenza di World Labs darà ad AMD una visione più diretta di come evolvono i workload, utile a orientare la roadmap. Le due aziende lavoravano insieme già dal 2025 sull’addestramento e sull’ottimizzazione dell’inferenza su GPU AMD, e Li racconta che Lisa Su è stata fra i primi investitori.
L’operazione si inserisce in un percorso visibile. Nell’agosto 2024 AMD ha chiuso l’acquisizione di Silo AI, laboratorio finlandese che il comunicato definiva il più grande laboratorio privato di AI in Europa, per circa 665 milioni di dollari; a marzo 2025 quella di ZT Systems, che progetta sistemi rack per data center. Il quadro è quello di una filiera completa: silicio, sistemi, lo stack software open source ROCm, laboratori di modelli e ora un gruppo che lavora su una classe di workload diversa da quella dei modelli linguistici.
La nostra lettura è che i world model abbiano un profilo di calcolo diverso. Dentro lo stesso flusso convivono generazione video ad alta risoluzione, ricostruzione 3D, rendering di Gaussian splat, simulazione fisica e soprattutto un numero molto alto di prove in parallelo: 2.000 prove simulate per checkpoint, moltiplicate per i checkpoint e per le varianti. World Labs dichiara inoltre che le prestazioni di Atlas crescono con il calcolo usato in addestramento e si aspetta che la tendenza regga, e una curva di questo tipo è ciò che interessa a chi progetta acceleratori. Sul piano competitivo NVIDIA offre già una famiglia di world model a pesi aperti, Cosmos, mentre secondo TechCrunch AMD finora aveva reso disponibili solo modelli testuali e video.
Li scrive di voler fornire “the best open models”. A oggi il motore real-to-sim-to-real è dichiaratamente proprietario e Atlas non è stato rilasciato con pesi aperti: cosa verrà pubblicato dopo la chiusura è una delle cose da verificare.
Far riprendere un reparto: cosa valutare prima
Nel metodo real-to-sim-to-real l’input è la ripresa di un compito reale in un luogo reale: il robot, i sensori, l’ambiente, gli oggetti, alcune dimostrazioni. Per ricostruire un ambiente da percorrere, nell’esempio di Atlas, bastano 24 fotogrammi di un video girato con il telefono. World Labs descrive ogni mondo ricostruito come infrastruttura riusabile: una volta ricostruito, un compito può servire a molte policy e a robot diversi, anche nel tempo. Per un’azienda manifatturiera significa che la ripresa di una cella o di un reparto diventa un bene con un valore proprio, e conviene trattarla come tale prima di consegnarla a un fornitore.
- Chi può riusare il mondo ricostruito. Il contratto deve dire se la ricostruzione e le policy addestrate su di essa possono servire ad altri clienti del fornitore e per quanto tempo.
- Segreto industriale. Una ricostruzione con geometria e dinamica rende visibili layout, attrezzature, tempi ciclo e parametri di processo. In Italia la tutela del segreto richiede che le informazioni siano sottoposte a “misure da ritenersi ragionevolmente adeguate a mantenerle segrete” (art. 98 del Codice della proprietà industriale): governare chi riprende, cosa e dove finiscono i dati fa parte di quelle misure.
- Le persone nelle riprese. Le dimostrazioni le eseguono gli operatori. Il video di persone al lavoro è un dato personale, e l’uso di telecamere da cui può derivare un controllo a distanza dell’attività va valutato alla luce dell’articolo 4 dello Statuto dei lavoratori, che lo ammette solo per esigenze organizzative e produttive, di sicurezza del lavoro o di tutela del patrimonio aziendale, e previo accordo sindacale o autorizzazione dell’Ispettorato del lavoro.
- I dati delle macchine. Per i dati generati da robot e macchinari connessi, il Data Act in applicazione dal 12 settembre 2025 prevede che il titolare dei dati, spesso il fabbricante, possa usare quelli non personali solo sulla base di un contratto con l’utente (art. 4, paragrafo 13).
C’è poi una questione tecnica. Atlas riempie le parti della scena che non ha visto con ciò che ritiene plausibile, e World Labs lo dice apertamente: più immagini riceve, meno immagina. In un’applicazione creativa è una qualità, in una cella dove un robot deve afferrare un pezzo è un rischio. La copertura della ripresa nelle zone in cui il robot entra in contatto con gli oggetti e la validazione di quei contatti fanno parte del lavoro di ingegneria, allo stesso titolo della scelta del modello.
Cosa monitorare
- Le autorizzazioni e la chiusura dell’operazione, prevista entro la fine del 2026.
- Cosa cambia per chi usa oggi Marble e la World API, su cui il comunicato non dice nulla.
- Se Atlas o altri modelli di World Labs verranno rilasciati con pesi aperti, come Li scrive di voler fare.
- Se gli strumenti di World Labs verranno portati sullo stack software di AMD e con quali condizioni per chi usa hardware di altri produttori.
- Validazioni indipendenti del metodo real-to-sim-to-real e risultati su compiti più lunghi e ambienti meno controllati della manipolazione da banco.
Fonti
- AMD, AMD to Acquire World Labs to Advance the Future of AI Compute
- Fei-Fei Li, To Seek a Newer World
- World Labs, About
- World Labs, Atlas: A World Model for Spatial Intelligence
- World Labs, Building Worlds That Train Robots
- World Labs, A Functional Taxonomy of World Models
- World Labs, Marble: A Multimodal World Model
- TechCrunch, AMD will acquire Fei-Fei Li’s World Labs for $8.2 billion
- AMD, AMD Completes Acquisition of Silo AI
- AMD, AMD Completes Acquisition of ZT Systems
- Mildenhall et al., NeRF: Representing Scenes as Neural Radiance Fields for View Synthesis (2020)
- Kerbl et al., 3D Gaussian Splatting for Real-Time Radiance Field Rendering (2023)
- OpenAI et al., Solving Rubik’s Cube with a Robot Hand (2019)
- Hans Moravec, Mind Children: The Future of Robot and Human Intelligence, Harvard University Press, 1988
- Regolamento (UE) 2023/2854, Data Act
- Codice della proprietà industriale, art. 98
- Statuto dei lavoratori, art. 4
- MindRACES: sistemi anticipatori e cognitive science
- A.K.I.R.A.