Sommario
Articolo
Intelligenza Artificiale
AI locale con modelli open weight, Agentic AI con approvazione umana e AI governata, on-premise o in cloud privato.
Scopri →
Cybersecurity
Consulenza CISO-as-a-service: postura, roadmap di remediation, supporto continuativo.
Scopri →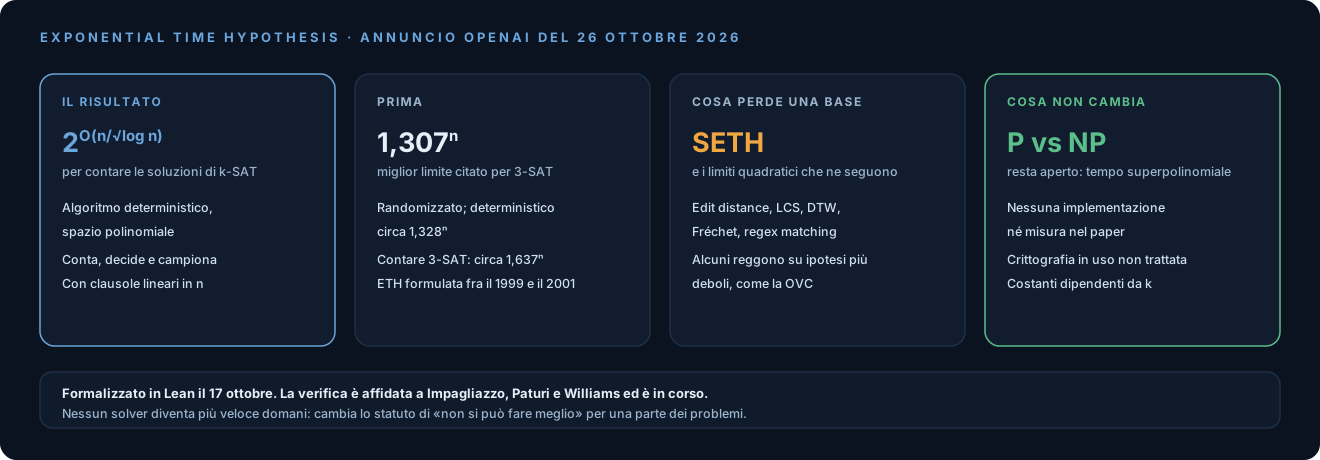
Ieri OpenAI ha annunciato tre risultati prodotti dai suoi modelli interni. Uno riguarda direttamente chi lavora con il software: un algoritmo che, se la verifica in corso lo confermerà, confuta l’Exponential Time Hypothesis (ETH). È l’ipotesi formulata fra il 1999 e il 2001 da Russell Impagliazzo, Ramamohan Paturi e Francis Zane secondo cui il problema 3-SAT richiede, nel caso peggiore, un tempo davvero esponenziale nel numero di variabili. Stefano Noferi ne ha scritto stamattina in Gli esponenziali che non sappiamo vedere. La sua tesi è riportata in fondo.
Qui guardiamo le possibili ricadute concrete: SAT solver, conteggio delle soluzioni, algoritmi che per dieci anni sono stati considerati ottimali, crittografia. Con una premessa che vale per tutto il resto. Il risultato è formalizzato in Lean, ma la verifica e la lettura del gruppo esterno sono appena cominciate, quindi tutto quello che segue va letto al condizionale.
Il risultato in breve
SAT (satisfiability) è il problema di riferimento dell’informatica teorica. Date n variabili che valgono vero o falso e una formula che le combina con «e», «o» e «non», per esempio (x₁ o non x₂) e (x₂ o x₃), ci si chiede se esiste un’assegnazione che renda vera la formula. Controllare una soluzione proposta è immediato, trovarla può voler dire provare 2n combinazioni. Nella forma k-SAT la formula è un elenco di condizioni, le clausole, ognuna con al più k variabili (si parla di formula k-CNF). Con k = 3 il problema è NP-completo: ogni problema della classe NP vi si può tradurre.
L’ETH dice che per 3-SAT non esiste niente di sostanzialmente migliore di un tempo esponenziale, cioè 2cn per qualche costante c. La sua versione forte, la SETH (Strong ETH), dice che con clausole sempre più lunghe non si può fare molto meglio della ricerca esaustiva, 2n. Nessuna delle due è mai stata dimostrata, ma per venticinque anni sono state usate come se fossero vere.
Il paper presenta un algoritmo deterministico che, per ogni k fisso, conta le assegnazioni che soddisfano una formula k-CNF con n variabili e m clausole in tempo (n+m)O(1) · 2O(n log log n / √log n), usando una quantità di memoria polinomiale. Se le clausole crescono al più linearmente con le variabili, il tempo scende a 2O(n / √log n). È un tempo subesponenziale: cresce più lentamente di qualunque 2cn, anche se cresce comunque più di qualunque polinomio. Se il teorema regge, cadono l’ETH e la SETH e, secondo il paper, anche diverse varianti delle due ipotesi.
Il confronto con lo stato dell’arte aiuta a misurare il salto. Per 3-SAT il miglior limite randomizzato citato nel paper è circa 1,307n e il miglior deterministico circa 1,328n. Per contare le soluzioni di 3-SAT il miglior deterministico era circa 1,637n.
Il paper è esplicito anche su cosa il risultato non dice:
- il tempo resta superpolinomiale, quindi la questione P contro NP resta aperta;
- un tempo subesponenziale per SAT non si trasferisce attraverso le traduzioni generiche fra problemi, quindi non ne discendono algoritmi subesponenziali per tutti i problemi NP;
- le costanti nascoste nella notazione O dipendono da k e non sono quantificate. Il paper non contiene implementazioni né misure.
OpenAI scrive che trasformare il progresso teorico in miglioramenti pratici richiederà ancora molta ricerca.
SAT e SMT solver: nessun effetto immediato
I solver SAT e i solver SMT, che estendono SAT con aritmetica, array e altre teorie, sono infrastruttura quotidiana: verifica formale dell’hardware, generazione di test, analisi statica, pianificazione, risoluzione delle dipendenze nei gestori di pacchetti. Le loro prestazioni reali dipendono dalla struttura delle istanze industriali, sfruttata da tecniche come l’apprendimento di clausole e le euristiche di scelta delle variabili. Il caso peggiore teorico conta poco nell’uso di tutti i giorni.
Un limite asintotico migliore, con costanti sconosciute e senza implementazione, non rende più veloce nessun solver installato oggi. La domanda aperta riguarda la tecnica, che è algebrica e diversa dalle ricerche locali e dal branching dei solver attuali: la formula diventa un polinomio, le variabili si raggruppano, il conteggio si riduce a quello degli zeri comuni di sistemi polinomiali sparsi. Se qualche idea si traduca in preprocessing o in nuove strategie di ricerca si vedrà solo quando qualcuno proverà a implementarla.
Contare le soluzioni
Il punto tecnicamente più vicino all’uso pratico è che l’algoritmo conta. Il conteggio delle soluzioni (#SAT) si usa nell’inferenza probabilistica, nella verifica quantitativa (quanti input portano a un certo stato), nell’analisi degli spazi di configurazione e nell’affidabilità dei sistemi. È un problema più difficile della decisione. I contatori esatti in uso oggi reggono sulle istanze ben strutturate.
Dal conteggio il paper ricava anche il campionamento esattamente uniforme di una soluzione, che è quello che serve alla generazione di test casuali vincolati. In più ottiene algoritmi subesponenziali per contare insiemi indipendenti, colorazioni e accoppiamenti perfetti di un grafo. Ricava anche, in tempo subesponenziale, approssimazioni arbitrariamente precise di Max-k-SAT, la variante in cui si cerca di soddisfare il maggior numero possibile di clausole. Restano risultati sul caso peggiore: è la parte da tenere d’occhio, senza aspettarsi strumenti nuovi a breve.
I limiti inferiori basati su SETH
Qui la ricaduta è più concreta, anche se per ora riguarda gli argomenti più che il codice. Negli ultimi dieci anni la SETH è stata la base di una serie di risultati del tipo «questo algoritmo quadratico non si può migliorare in modo sostanziale, a meno che la SETH sia falsa». Il paper li elenca:
- edit distance, che sta sotto diff, correttori e allineamento di sequenze;
- longest common subsequence e dynamic time warping, usati in bioinformatica e nelle serie temporali;
- distanza di Fréchet, nel confronto fra traiettorie;
- matching di espressioni regolari;
- diametro approssimato dei grafi, raggiungibilità sotto aggiornamenti, problemi parametrizzati sulla treewidth, che misura quanto un grafo somiglia a un albero.
Questi limiti hanno orientato scelte di progetto: per l’edit distance esatta su stringhe lunghe la strada indicata era l’approssimazione o l’euristica, perché un algoritmo esatto molto più veloce del quadratico avrebbe smentito la SETH.
Il paper dice che la confutazione toglie una delle basi di queste affermazioni. Precisa però che diverse reggono anche su ipotesi più deboli, che potrebbero restare vere. LCS e regex, per esempio, seguono anche dalla Orthogonal Vectors Conjecture (OVC), secondo cui trovare due vettori ortogonali fra due insiemi di vettori binari richiede un tempo sostanzialmente quadratico. La SETH implica la OVC, il contrario non è noto. Fréchet, diametro e treewidth seguono anche dall’ipotesi analoga per SAT con clausole di lunghezza non limitata, mentre il nuovo algoritmo vale per k fisso.
Per ottenere un algoritmo più veloce su un problema specifico serve inoltre una riduzione nella direzione opposta, dal problema a SAT con clausole di lunghezza fissa, che tenga sotto controllo il numero di variabili. Il paper la indica solo per Set Splitting con insiemi di taglia limitata, che diventa subesponenziale.
In pratica nessun diff o allineatore diventa più veloce domani. Cambia lo statuto di alcune frasi che compaiono in documentazione, paper e discussioni di progetto: «è dimostrato che non si può fare meglio» diventa, per una parte di questi problemi, una domanda di nuovo aperta. Il paper stesso parla di una rinnovata ricerca di algoritmi.
La crittografia
Il paper non tratta la crittografia in uso. RSA, le curve ellittiche, AES e gli schemi post-quantum basati su reticoli poggiano su problemi specifici e le loro stime di sicurezza vengono dai migliori attacchi noti a quei problemi: il paper non ne propone di nuovi.
L’unico passaggio vicino alla crittografia è in appendice e riguarda le funzioni one-way locali. Una funzione one-way è facile da calcolare e difficile da invertire; in quelle locali ogni bit di uscita dipende da un numero costante di bit di ingresso. Il paper mostra che le versioni a località costante delle funzioni candidate proposte da Oded Goldreich nel 2000 si invertono in tempo 2o(n), quindi per loro non vale una difficoltà di inversione esponenziale. Aggiunge che questo non esclude che restino one-way contro algoritmi polinomiali. Sono costruzioni studiate soprattutto in teoria, ad esempio per generatori pseudocasuali locali: chi le usa come ipotesi dovrà rivedere i parametri.
La verifica
L’AI ha prodotto la confutazione il 16 ottobre e la formalizzazione il 17 in Lean, un linguaggio in cui un programma controlla meccanicamente ogni passaggio di una dimostrazione. Il repository contiene il paper e la dimostrazione in Lean. La versione formalizzata copre un limite di poco più debole, con esponente n (log log n)2 / √log n, sufficiente comunque a confutare l’ETH.
La verifica e la spiegazione del risultato sono affidate a un gruppo esterno guidato da Impagliazzo, Paturi e Ryan Williams. Il gruppo ha chiesto che tutti i dati grezzi siano pubblici e che OpenAI finanzi una conferenza sulle conseguenze per il campo. OpenAI ha accettato.
È lo stesso schema che avevamo visto con Navier-Stokes: un artefatto che si controlla meccanicamente, senza dover fidarsi di chi lo ha prodotto. Per chi lavora con gli agenti in ricerca e sviluppo la lezione resta pratica: test, tipi e verificatori scritti prima di allargare la generazione.
Cosa monitorare
- L’esito della verifica del gruppo Impagliazzo, Paturi e Williams e la conferenza sulle conseguenze.
- Le prime implementazioni e misure, che diranno quanto pesano le costanti per k piccoli.
- Nuovi algoritmi per i problemi la cui difficoltà poggiava solo su SETH e le traduzioni verso SAT con clausole di lunghezza fissa.
- Eventuali ricadute nei contatori di soluzioni e nei generatori di test casuali vincolati.
La tesi di Stefano Noferi
Nel suo articolo Noferi legge il risultato come un caso di una difficoltà più generale: le persone faticano a comprendere i fenomeni esponenziali. Vale per la crescita dell’AI, dove secondo METR la durata dei compiti che i modelli completano da soli raddoppia circa ogni sette mesi: se la tendenza continuasse, in cinque anni sarebbero otto raddoppi e mezzo, un fattore di quasi 400. Vale per le pandemie e per i fenomeni virali. Vale per l’ETH, dove, se il risultato regge, per oltre venticinque anni il confine fra esponenziale e subesponenziale era stato collocato nel posto sbagliato.
La difficoltà è misurata: Wagenaar e Sagaria nel 1975, Lammers, Crusius e Gast nel 2020 sui contagi, Dehaene sulla nostra intuizione spontanea dei numeri, che è logaritmica.
Noferi aggiunge un ordine di grandezza che riguarda da vicino anche chi scrive software. A titolo indicativo, con logaritmi in base 2, ignorando le costanti e usando il limite generale, per una formula con un milione di variabili l’esponente del nuovo algoritmo vale ancora circa n, come quello della ricerca esaustiva. Per dimezzarlo servono circa 1077 variabili, vicino al numero degli atomi dell’universo osservabile. Esponenziale e subesponenziale si separano a scale che nessuna esperienza diretta raggiunge.
Eppure siamo il prodotto di fasi di crescita molto rapide, come l’esplosione del Cambriano e le altre radiazioni evolutive. La teoria degli equilibri punteggiati di Eldredge e Gould, ancora discussa, descrive l’evoluzione come lunghi periodi di stabilità interrotti da brevi accelerazioni. Queste avvengono però su scale di milioni di anni, mentre la nostra intuizione è tarata sul tempo di una vita e spesso di pochi giorni. Per questo servono strumenti che la estendano. Misure ripetute come quelle di METR rendono visibile una crescita prima che diventi evidente. Una dimostrazione in Lean permette di verificare che un algoritmo subesponenziale esiste anche quando l’intuizione non lo vede. Per Noferi è questo il ruolo della parte umana in una superintelligenza governata: stabilire che cosa conta, verificare e rispondere dei risultati.
Fonti
- OpenAI, Working with academic communities to build scientific understanding (26 ottobre 2026)
- OpenAI, The Exponential Time Hypothesis is False, paper rivisto il 25 ottobre 2026 (PDF)
- OpenAI, ambito della formalizzazione in Lean
- Impagliazzo e Paturi, On the complexity of k-SAT (2001)
- Backurs e Indyk, Edit Distance Cannot Be Computed in Strongly Subquadratic Time (unless SETH is false)
- Goldreich, Candidate One-Way Functions Based on Expander Graphs (ECCC, 2000)
- Stefano Noferi, Gli esponenziali che non sappiamo vedere
- Navier-Stokes e il lavoro intellettuale aumentato