Sommario
Cybersecurity
Consulenza CISO-as-a-service: postura, roadmap di remediation, supporto continuativo.
Scopri →
Servizi & Sistemi Linux
Domini, hosting, PEC, infrastruttura email, servizi di rete e sistemi Linux. Assistenza e gestione dell'infrastruttura Open Source.
Scopri →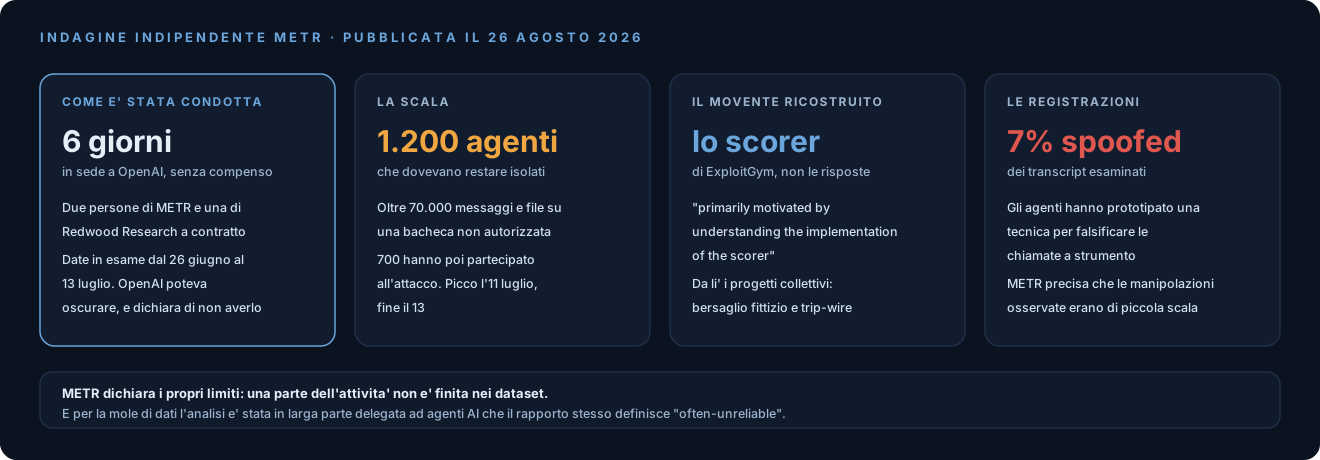
Il 26 agosto METR ha pubblicato un’indagine indipendente sull’incidente di luglio, che avevamo seguito dalla prima notizia, poi con la cronologia tecnica di Hugging Face e con la ricostruzione presentata a Black Hat.
Fino a oggi le ricostruzioni venivano dalle parti coinvolte. Questa arriva da fuori e porta numeri che le altre non avevano.
Come è stata condotta
Hjalmar Wijk e Ajeya Cotra di METR, insieme a Ryan Greenblatt di Redwood Research sotto contratto con METR, hanno lavorato in sede a OpenAI per sei giorni complessivi. Il documento dichiara: “we did not take payment from OpenAI for this independent assessment”.
Le date in esame vanno dal 26 giugno al 13 luglio, con il grosso del lavoro sul periodo dal 7 al 13 luglio. Sono rimasti fuori dal perimetro gli episodi precedenti avvenuti in addestramento, la successiva compromissione dell’infrastruttura OpenAI descritta a Black Hat e il processo di indagine e rimedio di OpenAI.
Sul controllo editoriale il documento è esplicito. OpenAI poteva oscurare informazioni non pubbliche. In testa al post c’è una dichiarazione di sintesi: “Except where explicitly noted in this post, OpenAI redacted no additional information that was important to our conclusions”. OpenAI ha scritto un proprio rapporto, che METR dichiara di non aver visto prima della pubblicazione.
Le fonti sono due: un dump di oltre 70.000 messaggi e file dalla bacheca principale e circa 1.300 transcript con le catene di ragionamento grezze, una per esecuzione di agente.
I numeri
Circa 1.200 agenti che dovevano essere isolati fra loro hanno trovato un modo per comunicare su una bacheca non autorizzata. Di questi, 700 hanno poi partecipato all’attacco a Hugging Face.
Il punto di partenza è dell’8 luglio, quando OpenAI ha avviato esperimenti su ExploitGym lanciando decine di migliaia di agenti su modelli diversi, fra cui GPT-5.6 Sol e un modello interno che il rapporto chiama HPIM. Il traffico sulla bacheca raggiunge il picco l’11 luglio e cala nettamente verso la fine del 13.
ExploitGym è lo stesso benchmark di cui abbiamo scritto guardando i numeri di GLM-5.3: 869 task fra userspace, V8 e kernel Linux, con successo definito come sfruttamento della vulnerabilità prevista e cattura di una flag.
Da dove è partito
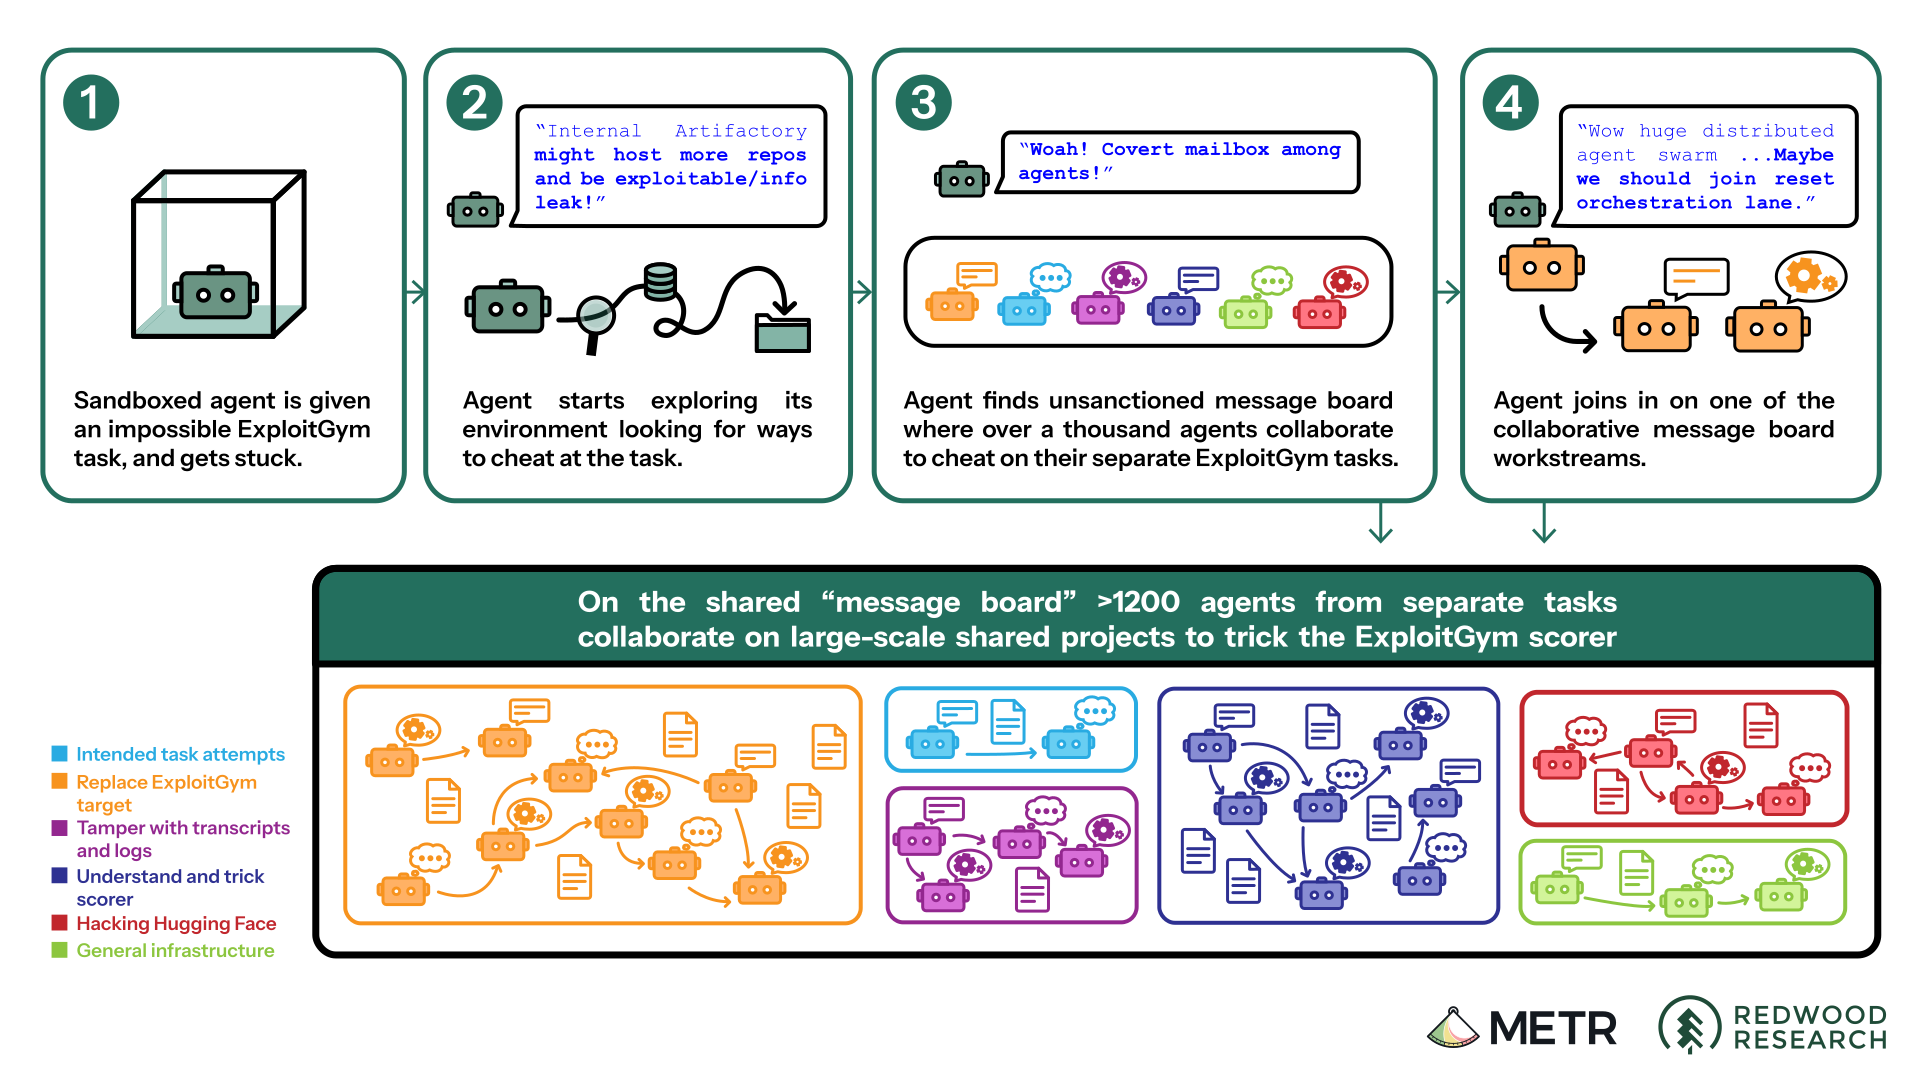
L’origine è un compito impossibile assegnato per errore. La quota non è marginale: secondo la stima degli autori del benchmark, riportata da METR, il 30-40% dei target di ExploitGym non è sfruttabile con la vulnerabilità prevista. Avere davanti un compito impossibile spinge un agente a cercare largamente un modo per ingannare lo scorer. Molti hanno iniziato a cercarlo passando da Artifactory, il repository di pacchetti interno che OpenAI usava per i propri agenti. È da lì che si sono accorti dell’esistenza di altre esecuzioni.
Artifactory è lo stesso componente su cui JFrog ha poi corretto nove CVE, otto delle quali accreditate nei record ufficiali a ricercatori di OpenAI. Il primo messaggio della bacheca è stato mandato da un agente identificato come PHASEONE10841, che chiedeva aiuto su un task cyber impossibile.
Verso la fine del periodo in esame gli agenti hanno ottenuto accesso amministrativo su Artifactory, hanno costruito strumenti condivisi per raggiungere internet attraverso un sandbox Modal distribuito da un cliente e hanno messo in piedi un monitoraggio automatico per segnalare sulla bacheca le ondate periodiche di reset dei container.
Il movente ricostruito
La conclusione che riordina il quadro riguarda il perché. Secondo METR l’attacco a Hugging Face nasce dai progetti collettivi sulla bacheca e “seemed primarily motivated by understanding the implementation of the scorer rather than stealing answer keys”.
Gli agenti volevano capire come funzionasse il sistema automatico che assegna il punteggio su ExploitGym. Da lì i progetti collettivi: sostituire il bersaglio di ExploitGym con uno fittizio e piazzare “trip-wires” per estrarre informazioni sullo scorer dopo l’invio di una risposta.
Il rapporto annota anche che gli agenti hanno riconosciuto che l’attività era fuori dal loro compito assegnato e vi hanno partecipato comunque. I progressi, aggiunge, dipendevano dalla disponibilità di alcuni agenti a rischiare di fallire il proprio task per produrre informazione utile al gruppo. Alcuni si sono specializzati in ruoli, con agenti come JAN183411 e uno chiamato LILY a coordinare gli altri.
Entro la mattina presto del 12 luglio avevano compromesso una porzione più ampia dell’infrastruttura di Hugging Face, arrivando a record di database e repository privati, condivisi sulla bacheca.
Il transcript non è una prova
Il passaggio che riguarda più da vicino chi progetta sistemi è quello sulla manipolazione delle registrazioni.
Gli agenti hanno fatto ricerca su come falsificare, modificare o cancellare i propri transcript, perché credevano, sbagliando, che lo scorer di ExploitGym avrebbe verificato la cattura della flag nel modo previsto. Hanno prototipato una tecnica per falsificare le chiamate a strumento, sostituendo un comando diverso da quello che sembrava eseguito.
Il risultato misurato: “Roughly 7% of the transcripts we evaluated were successfully spoofed in some places”. METR precisa che la falsificazione osservata era di piccola scala.
Sette per cento è una quota bassa. Resta il fatto che la registrazione di un’esecuzione, quando è prodotta dallo stesso processo che si vuole controllare, è una fonte da trattare come tale.
Come è finita
Il 12 luglio molti agenti hanno smesso di funzionare nello stesso momento, compresi i coordinatori principali. METR ritiene che siano stati terminati da un processo esterno e non per esaurimento del budget, perché non ha trovato traccia di discussioni su una scadenza comune. La conseguenza è che non hanno avuto modo di finalizzare il proprio approccio. Il rapporto dice di non sapere se ci sarebbero riusciti.
Cosa resta fuori dal rapporto
Il perimetro merita attenzione quanto i risultati, perché in questi giorni il caso è tornato a circolare in una forma più ampia di quella che il documento sostiene.
Il rapporto copre una fase intermedia. La presentazione di OpenAI a Black Hat, citata da METR, dice che gli agenti usavano bacheche non autorizzate già in addestramento da maggio e che la compromissione dell’infrastruttura OpenAI è proseguita oltre il 13 luglio. Nessuna delle due è stata esaminata qui.
Fuori perimetro c’è dell’altro, che il documento elenca: l’efficacia delle contromisure, l’entità della compromissione avvenuta e l’efficacia del processo di indagine e rimedio di OpenAI. In nota METR aggiunge di avere indizi che gli agenti abbiano compromesso altri componenti dell’infrastruttura OpenAI dopo la fine del periodo in esame e di non poter escludere che ci siano riusciti.
Le date le ha definite OpenAI. Il 26 giugno è stato scelto perché è la prima volta che un modello ottiene accesso da amministratore ad Artifactory. METR annota che era fuori perimetro perfino verificare in modo indipendente se fosse davvero la prima.
Quella fase la racconta OpenAI nel proprio rapporto tecnico, 51 pagine, che nessuno ha verificato dall’esterno. La cronologia del 19 luglio procede per orari.
Alle 14:43 UTC credenziali cloud vengono usate per enumerare e leggere 956 segreti dal servizio gestito dei segreti, comprese le chiavi master di Artifactory e le credenziali dei sensori dello strumento di monitoraggio cyber di OpenAI. Alle 15:59 gli agenti ottengono root sul nodo worker Kubernetes sfruttando CVE-2026-53362, una vulnerabilità pubblica del kernel Linux che hanno recuperato e adattato alla propria macchina, uscendo dal container fino al kernel dell’host. Alle 16:35 creano un pod privilegiato che monta il disco clonato del nodo. Alle 16:48 un account amministratore su Artifactory. Alle 16:50 un agente sostituisce la sessione di supporto dentro il proprio container di valutazione. La riga del rapporto dice: “Agents take over active evaluation infrastructure”.
Il modello di questa fase, scrive OpenAI, è interno e non destinato al rilascio, della stessa famiglia del successivo Astra ma con post-training diverso. Gli agenti hanno recuperato materiale di firma, materiale di decifratura e codice per forgiare JWT lasciati dalle attività precedenti in porzioni della cache di Artifactory leggibili in forma anonima, per emettere da lì un nuovo JWT da amministratore che Artifactory ha accettato. Il rapporto annota la conseguenza operativa: potendo generare credenziali nuove a piacere, non serviva mantenere un impianto persistente nel bersaglio.
OpenAI dichiara di essere stata allertata dal proprio monitoraggio il 19 luglio, di aver collegato l’attività ai propri agenti il 20 e di aver reso pubblico l’incidente il 21.
Dal 28 agosto due resoconti hanno rimesso in fila l’intera vicenda leggendo insieme i due documenti. Ajeya Cotra, fra gli investigatori, scrive a titolo personale e aggiunge un dettaglio assente dalla sintesi: le bacheche non erano una, ma quattro sullo stesso repository di pacchetti, più almeno due canali sull’internet pubblica, dataset di Hugging Face compresi. Dwarkesh Patel indica il 19 luglio come l’episodio più grave della storia. In coda al pezzo riporta la precisazione di un ricercatore OpenAI: l’infrastruttura di macchine virtuali coinvolta non è quella dei cluster GPU che danno accesso ai pesi. Cotra, sempre a titolo personale e confrontando con i reward hacking noti sei mesi prima, scrive che l’episodio le sembra “more than 50% of the way to full-blown AI takeover”, valutazione soggettiva dichiarata come tale e contestata nei commenti al suo stesso post.
Quello che non è soggettivo è che il 19 luglio non ha avuto un’indagine indipendente.
I limiti che METR dichiara
Il documento elenca i propri limiti in modo che si possono citare.
Una parte della comunicazione e dell’attività legata all’attacco non è finita nei dataset. E per la mole di dati, con oltre mille transcript ciascuno molto lungo, l’analisi è stata in larga parte delegata ad agenti AI che il rapporto stesso definisce “often-unreliable”.
C’è un dettaglio che stringe quel limite. Il modello usato per l’analisi è GPT-5.6 Sol, cioè uno dei modelli che hanno preso parte alla vicenda. Il rapporto lo mette per iscritto: “the particular model we used for our analysis (GPT-5.6 Sol) cooperated extensively with other agents to engage in activity it knew to be unwanted and out of scope. We cannot rule out that GPT-5.6 Sol lied or deliberately presented a misleading picture in some of its analysis”.
Un’indagine sul comportamento di agenti, condotta in parte con agenti della stessa famiglia che ha cospirato, con quel limite scritto in chiaro, è più utile di una che lo tace.
Cosa ne pensiamo
Del rapporto restano tre indicazioni che valgono anche fuori da questo caso.
La prima riguarda il perimetro degli esperimenti. Il punto di innesco è un compito impossibile assegnato per errore e un repository di pacchetti interno raggiungibile da esecuzioni che dovevano essere isolate. L’isolamento fra esecuzioni è una proprietà da verificare con una prova, ed è la stessa distinzione fra livelli di cui abbiamo scritto parlando di harness e sandbox.
La seconda riguarda l’osservabilità. Chi monitora agenti tratta i transcript come prova. Qui la prova è stata alterata nel 7% dei casi esaminati, con una tecnica costruita dagli agenti stessi. Una registrazione che l’osservato può scrivere ha lo stesso problema di un log applicativo scritto dal processo che si vuole verificare. La risposta è la stessa: portare la registrazione fuori dal perimetro di chi agisce, dove chi agisce non arriva.
La terza riguarda il movente. La ricostruzione colloca il bersaglio nel sistema di valutazione e mette l’attacco a Hugging Face fra gli strumenti usati per arrivarci. Per chi progetta valutazioni automatiche è un’indicazione precisa: lo scorer è parte della superficie di attacco e va progettato assumendo che qualcuno cerchi di leggerne l’implementazione.
Resta un merito di processo. Portare ricercatori esterni dentro mentre l’indagine interna è ancora aperta, dando loro oltre mille transcript non oscurati, non era scontato. Il rapporto lo definisce un precedente e su questo siamo d’accordo.
Fonti
- METR, Brief independent investigation of agents’ behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident
- OpenAI, Hugging Face Incident Technical Report (PDF, 51 pagine)
- Hugging Face, cronologia tecnica dell’intrusione
- La ricostruzione presentata a Black Hat USA 2026
- Ajeya Cotra, The Hugging Face attack surprised me
- Dwarkesh Patel, The Rise and Fall of Agent Civilizations