Sommario
Articolo
Intelligenza Artificiale
Consulenza EU AI Act: classificazione dei sistemi, policy, governance AI, formazione.
Scopri →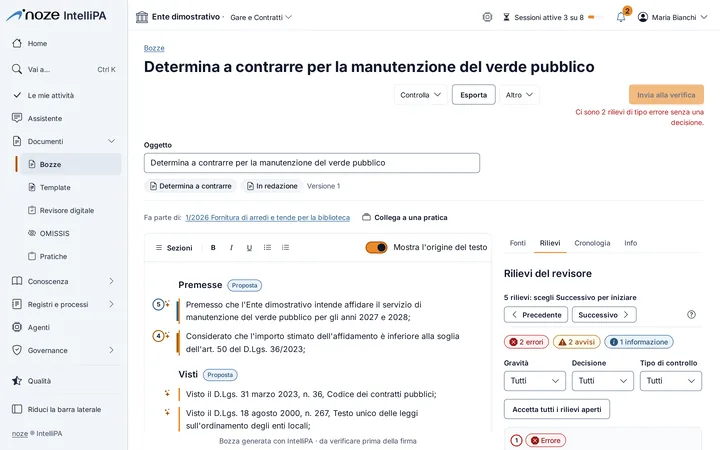
IntelliPA
AI agentica in locale, chiavi in mano, per Comuni ed enti pubblici: bozze di atti, risposte con la fonte e registri di conformità su una workstation in sede.
Scopri IntelliPA →
Cybersecurity
Consulenza CISO-as-a-service: postura, roadmap di remediation, supporto continuativo.
Scopri →
Il 12 novembre la Gazzetta ufficiale dell’Unione europea, serie C, ha pubblicato gli orientamenti della Commissione sugli obblighi di trasparenza dell’articolo 50 dell’AI Act (C/2026/6005). Sono 43 pagine con definizioni, criteri ed esempi per chi sviluppa o usa chatbot, agenti, sistemi generativi, riconoscimento delle emozioni e categorizzazione biometrica. La Commissione li aveva messi online in inglese il 20 luglio, prima che gli obblighi diventassero applicabili il 2 agosto.
Gli orientamenti non sono vincolanti: l’interpretazione definitiva del regolamento spetta alla Corte di giustizia dell’UE. Sono scritti però anche per le autorità competenti, perché l’articolo 50 venga applicato in modo coerente e uniforme.
Quattro obblighi e chi ne risponde
| Paragrafo | Sistemi | Chi | Obbligo |
|---|---|---|---|
| 50.1 | sistemi che interagiscono direttamente con le persone | fornitore | informare che si sta interagendo con un sistema di IA |
| 50.2 | sistemi che generano o manipolano audio, immagini, video o testo | fornitore | marcare gli output in formato leggibile dalle macchine e renderli rilevabili |
| 50.3 | riconoscimento delle emozioni e categorizzazione biometrica | deployer | informare le persone esposte |
| 50.4 | deepfake e testi pubblicati su questioni di interesse pubblico | deployer | dichiarare che il contenuto è generato o manipolato |
Il paragrafo 5 vale per tutti: l’informazione va data in modo chiaro e distinguibile, al più tardi alla prima interazione o esposizione, nel rispetto dei requisiti di accessibilità. Gli obblighi si sommano: il fornitore di un assistente che genera immagini in conversazione può dover rispettare sia il paragrafo 1 sia il 2, e il deployer che lo usa a fini professionali per produrre un deepfake può avere in più l’obbligo del paragrafo 4.
Fornitore o deployer
Gli orientamenti dedicano molto spazio ai ruoli, perché da lì dipende chi deve fare cosa.
- Chi modifica e rimarchia diventa fornitore. Un’impresa che modifica un sistema generativo di terzi, per esempio con nuovi dati di addestramento, e lo mette in servizio con il proprio nome diventa fornitore del nuovo sistema. Lo è anche un ente pubblico che sviluppa internamente un chatbot e lo usa per sé con il proprio nome.
- Il deployer è chi decide l’uso. Conta l’autorità sul sistema, cioè la decisione su finalità e modalità d’impiego, non il controllo tecnico. I dipendenti che lavorano sotto le istruzioni dell’organizzazione non sono deployer distinti. Un’impresa che si limita a commissionare uno spot a un’agenzia, senza decidere se e come l’agenzia usa l’IA, non è deployer.
- Le piattaforme che ospitano non sono deployer. Chi si limita a diffondere contenuti generati da altri, senza autorità sull’uso del sistema di IA, non ha obblighi dall’articolo 50, ma è fortemente incoraggiato a conservare marcature ed etichette. Le grandi piattaforme diventano fornitori o deployer quando integrano o usano sistemi di IA per scopi propri.
- Open source. I sistemi di IA rilasciati con licenza libera e open source restano soggetti all’articolo 50. Non lo sono i componenti che da soli non costituiscono un sistema, come software, dati, modelli, strumenti e servizi.
L’articolo 50 non si applica direttamente ai modelli per finalità generali, ma la Commissione incoraggia chi sviluppa questi e altri modelli generativi a predisporre già a livello di modello l’identificazione dei sistemi interattivi e la marcatura dei contenuti, per semplificare il lavoro dei fornitori a valle.
Chatbot e agenti: il paragrafo 1
Rientrano nel paragrafo 1 i sistemi destinati a interagire direttamente con le persone in uno scambio bidirezionale: assistenti vocali, chatbot, avatar, robot, compagni IA, animali da compagnia robotici, bot sui social e anche gli agenti di programmazione. Restano fuori i sistemi di raccomandazione, i filtri antispam, la traduzione e la trascrizione automatica, il completamento del testo e del codice, i sistemi di supporto alle decisioni in back-end e le chiamate da macchina a macchina.
Sugli agenti gli orientamenti sono espliciti (punto 31). Un agente che, nel prenotare, acquistare, gestire la corrispondenza o negoziare, interagisce con persone deve dichiarare la propria natura artificiale e la persona per conto della quale agisce. Se il fornitore non può sapere in anticipo se l’agente incontrerà persone, l’agente dovrebbe essere progettato a livello di architettura per dichiararsi ogni volta che è ragionevolmente probabile. Dovrebbe dichiararsi anche a chi lo istruisce, nei momenti chiave come autorizzazioni, segnalazioni e convalide, e in ogni nuova interazione. In una nota la Commissione indica gli attestati dei portafogli europei di identità digitale e dei proposti portafogli europei delle imprese come strumento possibile per identificare un agente in modo verificabile.
La forma dell’avviso è libera, purché rispetti il paragrafo 5 e tenga conto di minori, anziani e persone con disabilità quando il sistema può incontrarli. Alcune soluzioni da sole non bastano:
- l’avviso solo nelle condizioni d’uso, in un URL o nella documentazione;
- una marcatura leggibile dalle macchine che l’utente non vede;
- riferimenti generici come «assistente» o un’interfaccia che fa sembrare umano il sistema;
- una nota generale del tipo «i servizi di questo sito utilizzano l’IA»;
- descrizioni tecniche come «questo sistema utilizza LLM».
Nella maggior parte dei casi un avviso ben visibile prima della prima interazione è probabilmente sufficiente; la Commissione raccomanda di collocarlo vicino al campo in cui si scrive. Promemoria periodici sono probabilmente necessari con persone vulnerabili, in contesti sensibili o immersivi e dove il rischio di essere indotti in errore è più alto, come consulenza finanziaria, assicurazioni, assistenza legale, sanità, gestione dei reclami e compagni IA. Il sistema deve comunque dichiararsi ogni volta che qualcuno gli chiede se è un’IA o quando dallo scambio si capisce che la persona potrebbe essere confusa.
L’eccezione per l’interazione «evidente» va letta in modo restrittivo: vale per un assistente alla programmazione riservato a sviluppatori professionisti o per un assistente interno usato da personale formato (risorse umane, ufficio legale, acquisti, compliance, IT), mentre un chatbot di assistenza aperto al pubblico deve dichiararsi.
Marcatura e rilevazione: il paragrafo 2
Il fornitore di un sistema generativo deve fare due cose: marcare gli output in un formato leggibile dalle macchine e garantire che siano rilevabili. Una sola delle due non basta. Gli strumenti di rilevazione devono essere accessibili al pubblico, basati su standard di settore e idealmente eseguibili in locale sul dispositivo. Finché mancano norme armonizzate, il fornitore può usare una soluzione propria o di terzi, purché interoperabile con quelle degli altri.
Tra le tecniche citate dal considerando 133 ci sono filigrane, metadati, metodi crittografici di provenienza, registri e impronte digitali, anche combinati. Non serve conservare l’intera catena di provenienza del contenuto. La soluzione deve essere efficace, affidabile, solida contro modifiche e attacchi e interoperabile, secondo lo stato dell’arte. Il limite del «tecnicamente possibile» è oggettivo e non dipende dalle risorse del singolo fornitore. La marcatura non dovrebbe trattare informazioni sull’autore del contenuto.
Restano fuori dal paragrafo 2:
- output brevi come parole singole, didascalie, testo alternativo ed etichette dell’interfaccia;
- il codice sorgente, commenti compresi, e anche SQL, infrastructure as code, YAML, JSON, script e configurazioni;
- la comunicazione da agente ad agente che non arriva alle persone e i passaggi intermedi di un agente, come il ragionamento o le azioni nel browser;
- il lavoro intermedio nei flussi di produzione chiusi, dove va marcato solo il risultato finale.
Non va marcato nemmeno l’editing standard: correzioni grammaticali, formattazione, compressione, piccole regolazioni di colore e le traduzioni generate dall’IA, che però possono ricadere nel paragrafo 4 se si tratta di testi di interesse pubblico. Vanno marcati invece i riassunti, le parafrasi che cambiano stile o significato, la sostituzione di volti e oggetti e la sintesi realistica della voce di una persona specifica.
Per le applicazioni industriali e tra imprese, esclusi i sistemi rivolti al pubblico e ai consumatori, c’è un’esenzione con tre condizioni cumulative: output strettamente tecnico, destinato a poche persone predefinite dentro l’organizzazione del fornitore e del deployer, non condiviso fuori dall’impresa e protetto con tutele contro gli usi impropri, come isolamento nel cloud e controlli basati sui ruoli.
Deepfake e testi: il paragrafo 4
Un deepfake è un’immagine, un audio o un video generato o manipolato che assomiglia in modo notevole a persone, oggetti, luoghi, entità o eventi reali o plausibili e che può apparire falsamente autentico o veritiero. Tra gli esempi della Commissione sono deepfake l’avatar sintetico realistico di un amministratore delegato che si congratula con i dipendenti e l’immagine pubblicitaria di un prodotto che lo fa sembrare migliore di com’è; un drago o un elefante alla guida, invece, non sono realistici e restano fuori. L’etichetta deve essere visibile o udibile senza strumenti tecnici: il deployer non può affidarsi alla marcatura del fornitore. Per le opere manifestamente artistiche, creative, satiriche o di finzione l’obbligo è attenuato, ma se un contenuto ha anche carattere informativo prevale l’obbligo pieno.
Per i testi l’obbligo riguarda quelli pubblicati per informare il pubblico su questioni di interesse pubblico, tra cui la pubblica amministrazione e i servizi pubblici. Tra gli esempi della Commissione c’è il riassunto generato dall’IA di un articolo su una delibera del consiglio comunale. I testi su un’intranet aziendale non sono pubblicati.
L’etichetta non serve se ci sono insieme revisione umana o controllo editoriale e una persona fisica o giuridica con la responsabilità editoriale, cioè la responsabilità giuridica finale della pubblicazione; identità e contatti andrebbero resi pubblici. La revisione deve entrare nel merito, da parte di persone con competenze e giudizio professionale pertinenti, e comprende almeno la verifica dei fatti. Non bastano un controllo ortografico, l’esistenza di una policy editoriale, una revisione automatica o un’approvazione sommaria. Se l’IA modifica il testo in modo sostanziale dopo l’approvazione, l’eccezione decade.
Codice di buone pratiche e scadenze
Il codice di buone pratiche sulla trasparenza dei contenuti generati dall’IA, pubblicato il 10 giugno, è stato giudicato adeguato dalla Commissione l’8 luglio per i paragrafi 2, 4 e 5. A fine luglio lo avevano firmato circa 190 organizzazioni. Chi aderisce viene controllato sull’attuazione del codice. Chi non aderisce deve dimostrare la conformità con altri mezzi, per esempio un’analisi delle differenze rispetto al codice, e può ricevere più richieste di informazioni. L’UE ha pubblicato anche un set di icone per etichettare i contenuti, il cui uso è facoltativo.
Le sanzioni arrivano a 15 milioni di euro o al 3% del fatturato mondiale annuo dell’esercizio precedente, se superiore. Per le PMI vale l’importo più basso dei due.
L’articolo 50 si applica dal 2 agosto 2026 a tutti i sistemi, anche a quelli già sul mercato. Il Digital Omnibus (regolamento (UE) 2026/1744) concede un periodo transitorio solo per marcatura e rilevazione (paragrafo 2) dei sistemi generativi immessi sul mercato o messi in servizio prima del 2 agosto, che devono adeguarsi entro il 2 dicembre 2026. Per i sistemi in parte interattivi e in parte generativi la proroga vale solo per la marcatura: l’avviso di interazione con l’IA è dovuto dal 2 agosto. I contenuti prodotti prima del 2 agosto non vanno marcati né etichettati retroattivamente, ma un testo generato prima e pubblicato dal 2 agosto in poi va etichettato.
Cosa ne pensiamo
Per chi costruisce agenti il punto 31 è il più operativo. Un agente che scrive e-mail o risponde per conto di un ufficio, quando dall’altra parte c’è una persona, deve presentarsi come agente e dire per chi lavora, e dovrebbe farlo anche verso chi lo istruisce nei passaggi di autorizzazione. Quando gli interlocutori non sono prevedibili, gli orientamenti chiedono che l’agente sia progettato «a livello di architettura» per dichiararsi: va previsto nel modo in cui l’agente è costruito, oltre che nelle sue istruzioni.
Per la pubblica amministrazione conta la sezione sui testi. In IntelliPA le bozze di atti mostrano l’origine del testo e il Responsabile le verifica prima della firma. Gli orientamenti chiariscono che quella verifica vale come revisione umana se entra nel merito, con il controllo dei fatti e delle fonti, e che un intervento sostanziale dell’IA dopo l’approvazione fa decadere l’eccezione. Serve inoltre che l’ente detenga la responsabilità editoriale della pubblicazione.
Per i fornitori di sistemi generativi già sul mercato mancano dodici giorni al 2 dicembre. La lista di quello che era già dovuto dal 2 agosto è nella checklist dell’AI Act; il calendario dell’Omnibus è in Digital Omnibus verso l’adozione formale.
Fonti
- Gazzetta ufficiale dell’UE, C/2026/6005, Orientamenti sull’attuazione degli obblighi di trasparenza per determinati sistemi di IA a norma dell’articolo 50
- Commissione europea, Guidelines on transparency obligations for providers and deployers of AI systems
- Commissione europea, Code of Practice on Transparency of AI-generated Content
- Commissione europea, parere sulla valutazione del codice di buone pratiche
- Commissione europea, icone UE per l’etichettatura dei contenuti generati dall’IA
- Regolamento (UE) 2024/1689, AI Act
- Regolamento (UE) 2026/1744, Digital Omnibus sull’IA